背景:聊着聊着就停了
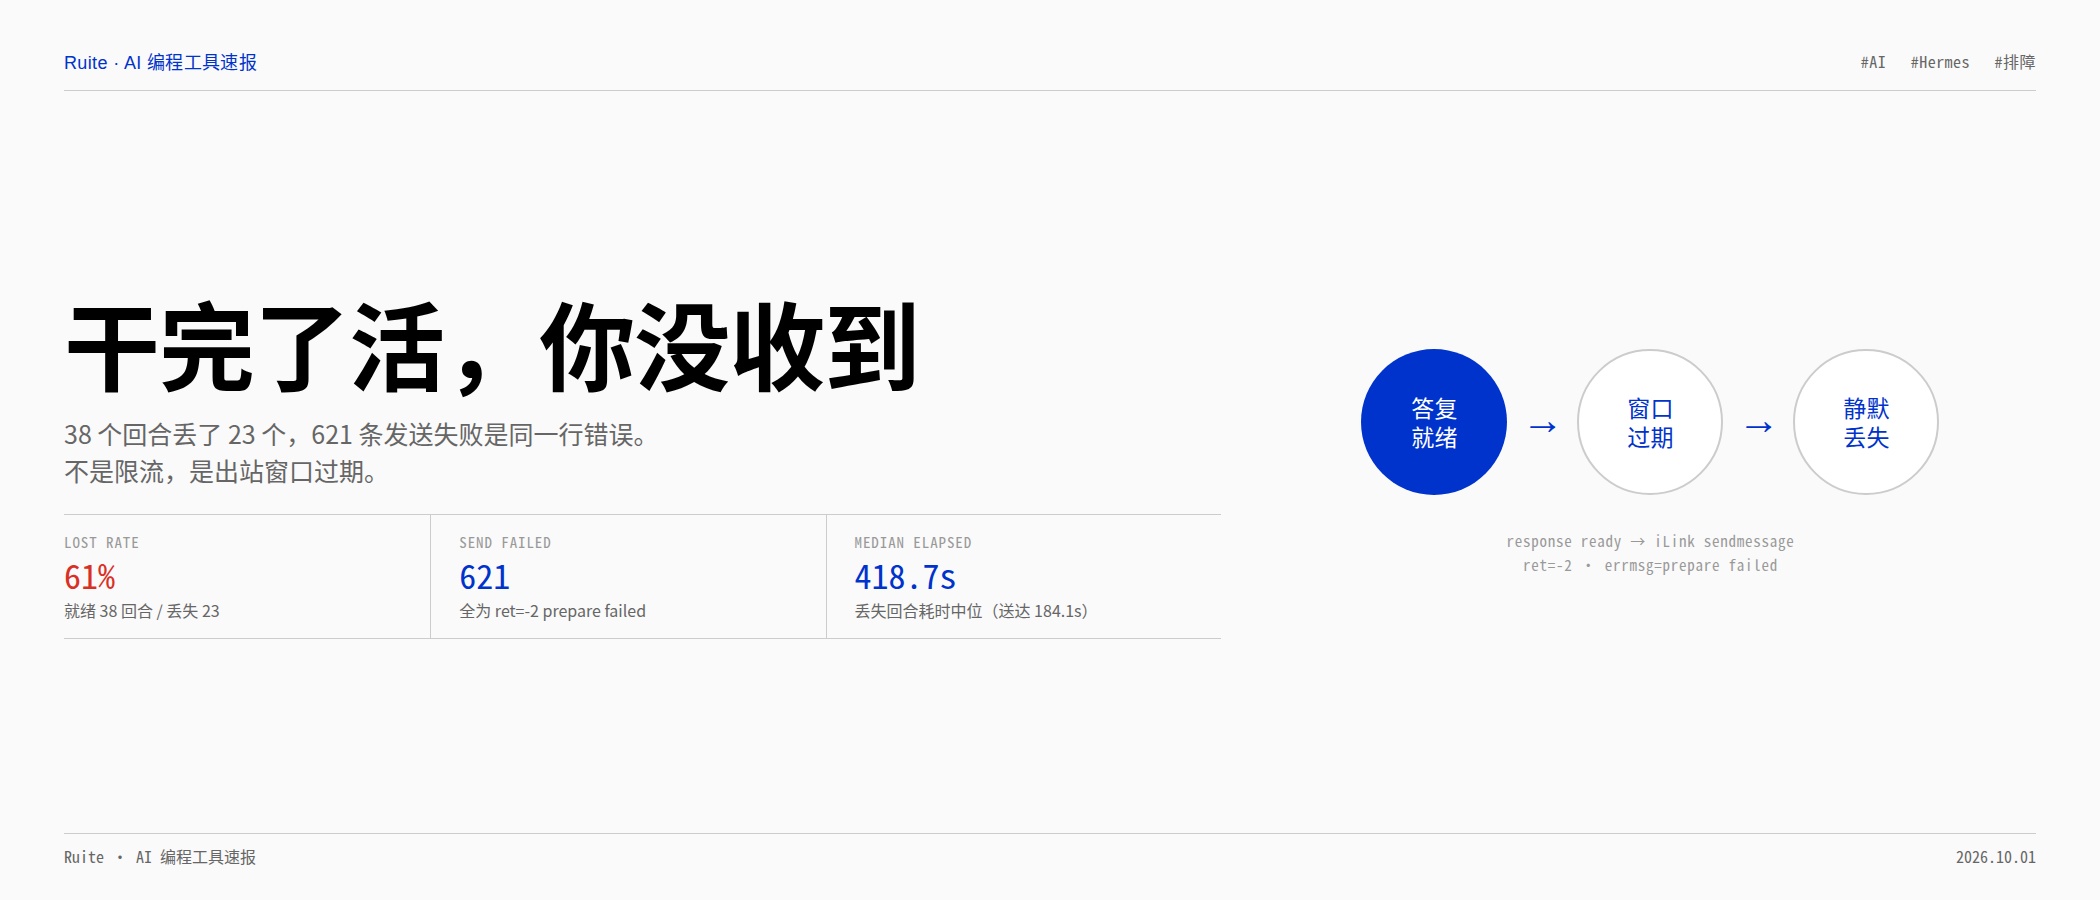
微信上问了 Hermes 一个问题,它开始干活。等了十几分钟,没有下文。
你的第一反应可能是”它卡住了”或者”它不搭理我”。实际情况是:它干完了,答复写好了,日志里也写着 response ready。但那句话根本没发出去。
更糟的是,用户侧完全静默。没有错误提示,没有重发,没有告警。只有服务端日志里一行 ERROR。
我把这个现象叫静默丢失。失败本身可以忍,静默不可忍,因为它让你把”没收到”误判成”AI 没在干活”,或者”系统挂了”,而真正的原因藏在日志里。
症状:三行日志说完整件事
在网关日志里按时间戳抓一段,真相就出来了:
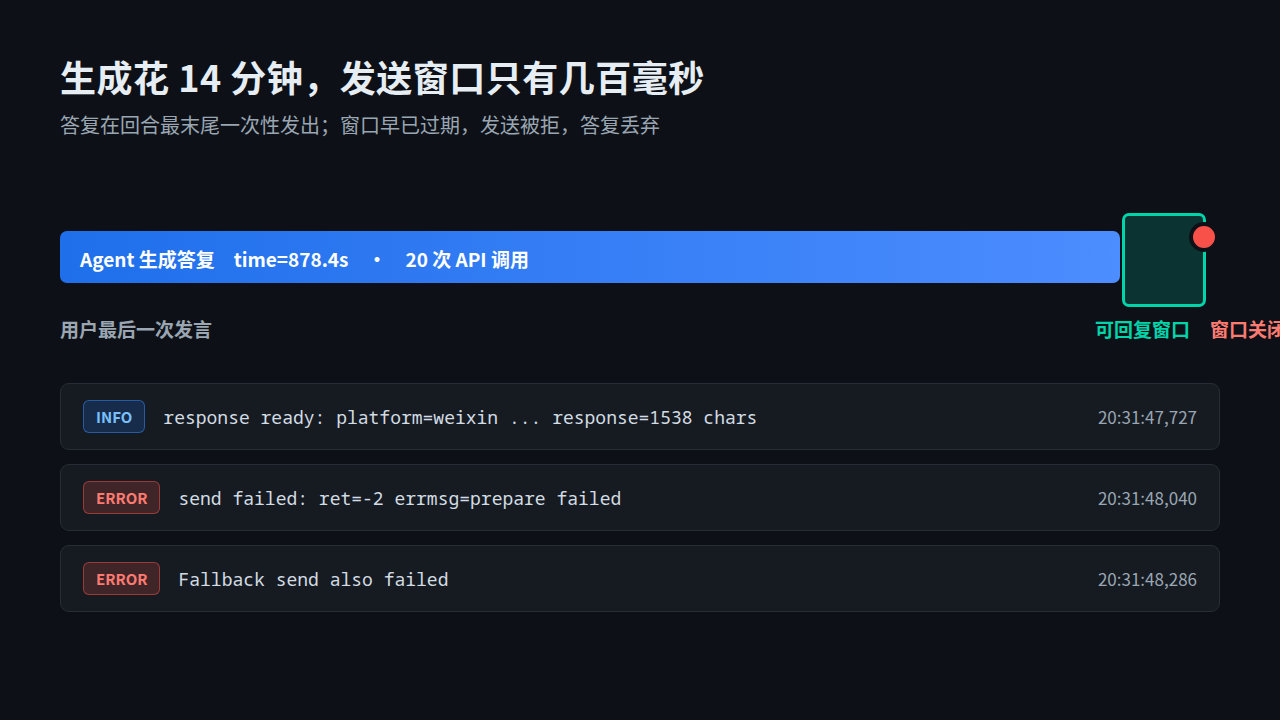
20:31:47,727 INFO  gateway.run: response ready: platform=weixin ... time=878.4s api_calls=20 response=1538 chars
20:31:48,040 ERROR gateway.platforms.weixin: [Weixin] send failed to=<PEER>: iLink sendmessage session not ready: ret=-2 errcode=None errmsg=prepare failed
20:31:48,286 ERROR gateway.platforms.base: [Weixin] Fallback send also failed
三行连读:答复就绪了(跑了 878 秒、20 次 API 调用、1538 字),一秒后发送失败,备用路径也失败,答复就此消失。
注意时间差。生成花了 14 分钟,发送窗口只有几百毫秒。问题不在生成,在发送。
根因:三层叠加,缺一层都不会丢
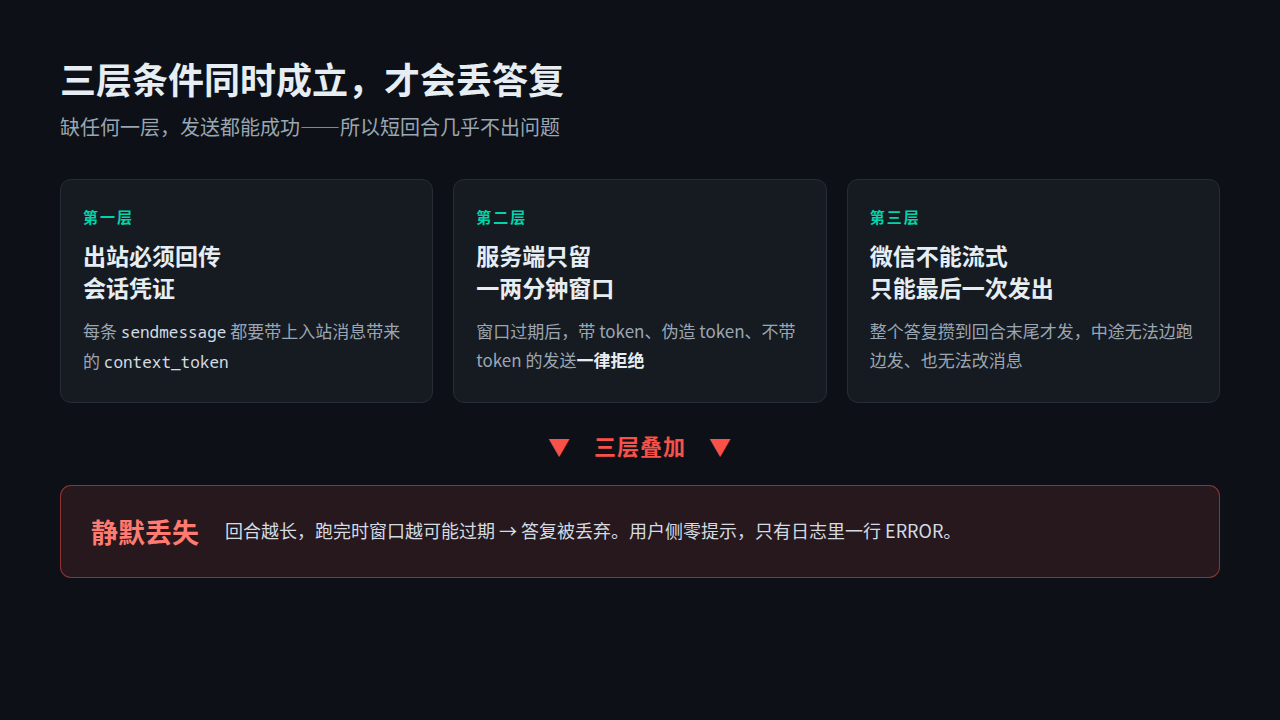
拆开看,这个失败需要三个条件同时成立:
第一层,协议要求带上会话凭证。 每条出站 sendmessage 必须回传入站消息带来的 context_token。
第二层,服务端有一个一两分钟的可回复窗口。 超过窗口,服务端会拒绝 bot 发起的任何发送,返回 ret=-2 加 errmsg=prepare failed。注意是”任何”:带 token 的、伪造 token 的、完全不带 token 的,一律拒绝。
这一点很关键,因为代码里就有”重试时去掉 token”的兜底逻辑,注释说这是降级通道。实测证明走不通:窗口过期后,不带 token 重试照样失败。
第三层,微信不能流式输出。 适配器里 SUPPORTS_MESSAGE_EDITING = False,注释写着 WeChat cannot edit; streaming must send-final-only。别的平台可以边想边发、边改消息,微信只能把整个答复攒到回合最末尾一次性发出。
三层叠加:回合跑得越久,跑完时窗口越可能过期,答复越可能被丢弃。 这跟”聊着聊着就停了”的体感完全对上。不是随机断,是长回合更容易断。
排查第一坑:别把 ret=-2 当成限流
这是整个排查里最容易走错的一步。
-2 在代码里被注释成 “iLink frequency limit — backoff and retry“,翻译过来就是频率限制。按这个思路排查,你会去调节流参数、降低发送频率、加退避。全都没用,因为根本不是限流。
怎么证伪?把错误字段唯一化:
# 当天全部失败行里,每个字段各有几种取值
grep "2026-09-30.*send failed to=" ~/.hermes/logs/gateway.log \
  | grep -oE "ret=-?[0-9]+" | sort -u
grep "2026-09-30.*send failed to=" ~/.hermes/logs/gateway.log \
  | grep -oE "errmsg=[A-Za-z ]+" | sort -u
实测结果:
ret     : -2      (621/621)
errmsg  : prepare failed — the user must send the bot a message first (or re-pair)  (621/621)
errcode : None    (621/621)
上面第二条命令用了 grep -oE "errmsg=[A-Za-z ]+",只会截出英文单词和空格,所以实际打印出来是 errmsg=prepare failed,后面那截中文语境之外的说明(”the user must send the bot a message first (or re-pair)”)被正则吃掉了。看截断版没问题,但我把完整串贴在这里,免得你照抄命令后以为日志里只有半句。
621 条失败,三种字段各自只有一个取值。 限流会随时间波动、会在退避后自愈、会伴随不同错误串;这里是一条错误从头到尾没有变化。再看当天”rate limited”字样的出现次数是 0,分类逻辑已经能正确识别这种 stale session,不再误报限流。
顺手排掉的另外两个假设:
不是本地 token 过期。 ContextTokenStore 是磁盘缓存,按 account_id:user_id 做键,没有 TTL 参数。判定发生在服务端,跟客户端存的字符串无关。
不是账号需要重新配对。 同一天同一小时里,失败和成功交替出现。账号健康,是时序问题。
排查第二坑:平台过滤,一个假阳性就能带偏结论
把答复就绪和失败配对、算每个回合的送达与否,逻辑很简单。但有个细节能让整个结论反向。
response ready 这行日志不只属于微信。定时任务、其他平台的消息也会写这行,只是字段不同:
response ready: platform=ntfy chat=hermes-...
response ready: platform=weixin chat=...
如果配对时不做平台过滤,把 ntfy 的成功也算进微信,就会出现一个”间隔 172 分钟仍然送达”的离群点。这一个假阳性,足以把”存在可回复窗口”的结论带偏成”窗口根本不存在”。
正确写法是精确匹配 platform=weixin,而不是判断整行里是否含 “weixin” 字符串:
DISPLAY = re.compile(r"platform=(\w+)")
pm = DISPLAY.search(line)
if pm and pm.group(1) != "weixin":
    continue          # 关键:只保留微信平台的回合
这个坑我踩过一次,而且更讽刺的是:出错的诊断脚本,注释里写着”必须按 platform 过滤”,代码里却只做了宽松的字符串包含判断。注释和实现不一致的脚本,比没有脚本更危险。
实测:38 个回合,丢了 23 个
把工具跑起来:
python3 scripts/diag-weixin-delivery.py 2026-09-30
输出摘要:
答复就绪 38 次,彻底丢失 23 次 → 丢失率 61%
丢失回合耗时中位 418.7s / 送达回合耗时中位 184.1s
按「距用户上次发言的间隔」分桶,边界就露出来了:
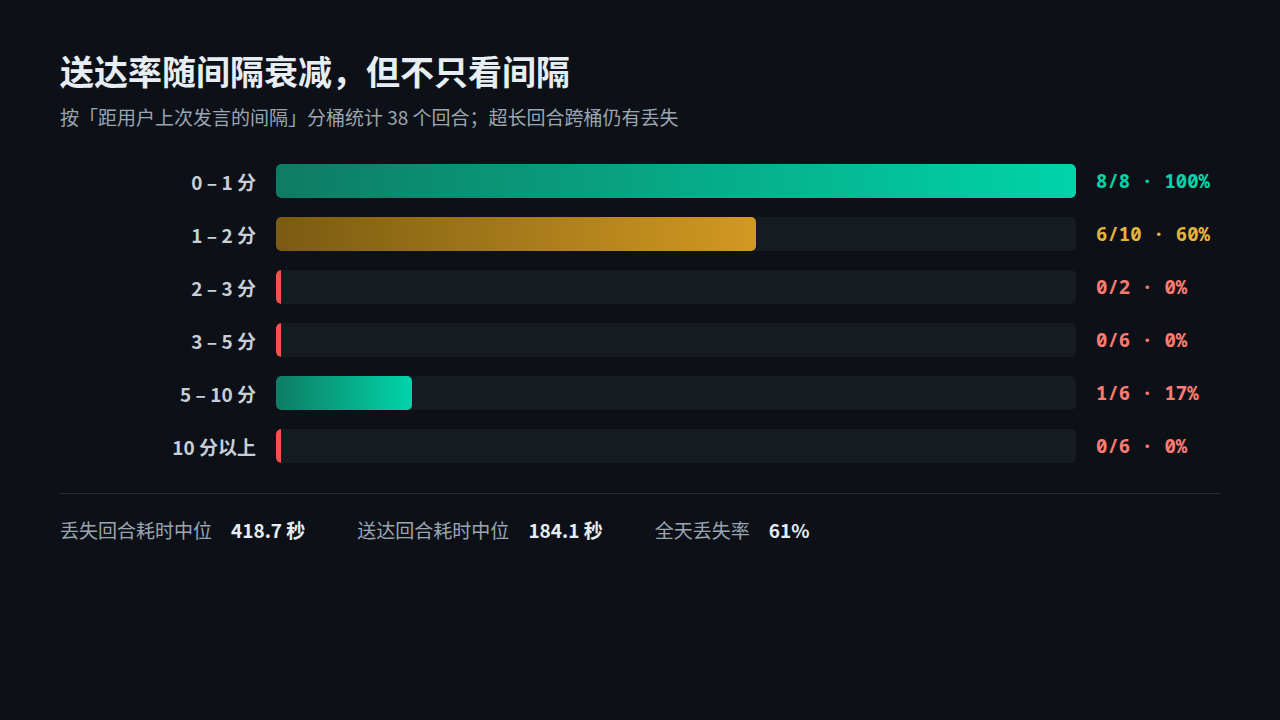
一分钟内发言,全中;超过两分钟,基本没戏。
但别急着写成”间隔超过两分钟必丢”。表格里有两个反例:间隔 1.5 分和 1.7 分的回合照样丢了,而它们的回合耗时分别是 1124 秒和 1426 秒,同样的超长。所以正确表述是”距上次发言的间隔和回合耗时共同决定“,单变量解释不了。
好用的技巧:先找突变日,再谈概率
“丢失率 61%”这个数字很抓眼球,但对定位问题没什么帮助。真正有用的是趋势。
for d in 2026-09-25 2026-09-26 2026-09-27 2026-09-28 2026-09-29 2026-09-30; do
  printf "%s ready=%s lost=%s fail=%s\n" $d \
    $(grep -c "$d.*response ready.*platform=weixin" gateway.log) \
    $(grep -c "$d.*Fallback send also failed" gateway.log) \
    $(grep -c "$d.*\[Weixin\] send failed to=" gateway.log); done
2026-09-25 ready=0  lost=0  fail=6
2026-09-26 ready=0  lost=0  fail=10
2026-09-27 ready=0  lost=0  fail=6
2026-09-28 ready=5  lost=0  fail=8
2026-09-29 ready=15 lost=5  fail=81
2026-09-30 ready=38 lost=27 fail=621
前四天失败数稳定在个位数,丢失数为零。9 月 29 日突然抬头,9 月 30 日失败数是前一天的七倍多。
注意这里的 lost=27 和前面标题里的”丢了 23 个”不是同一个数。 两者定义不同:lost 列直接数 Fallback send also failed 的日志行数(27 行),而交付率脚本是把每个 READY 与 5 秒内的 LOST 配对后再计数(23 个回合)。差额 4 就是落在窗口外、没能和某个回合配上的失败行。写文章时我把两个数都留着,因为它们各自用在自己的语境里——但如果你只看到一个数,会以为其中一个是错的。
这是一条可归因的时间线。 有了突变日,你才能去问”那天前后发生了什么变更”;只有概率没有趋势,这个问题会永远停在”偶发”。
连带影响:cron 投递目标的一个陷阱
同一个根因还牵出了几个定时任务。检查任务的投递错误字段:
import json, os
d = json.load(open(os.path.expanduser("~/.hermes/cron/jobs.json")))
for j in (d if isinstance(d, list) else d.get("jobs", d)):
    if j.get("last_delivery_error"):
        print(j["name"], j.get("deliver"), j["last_delivery_error"][:60])
16 个任务里有 5 个处于投递失败状态,错误全是同一条 iLink sendmessage session not ready。
其中 3 个的投递目标是 origin,不是 weixin。
这就是坑点:想排查”哪些任务在往微信推”,只 grep deliver=weixin 会漏掉一半。 origin 会解析回消息的来源通道。如果那个任务本来就是从微信会话触发的,最后一样是往微信推,一样中招。
处置:先止损,再谈修复
立刻可用,零风险
- 把微信回合压到一分钟以内。 窗口只有一两分钟,长分析必然丢。做法是先回一句”收到,我去查”,干完再单独发结果;把大任务拆成多次短回合,而不是让它一口气跑十分钟。
- 长任务改走不设窗口的通道。 消息推送类通道(如 ntfy)和邮件都没有这个限制,实测间隔一百多分钟仍能送达。长报告、日报这类内容更适合走那边。
- 检查定时任务时,把
origin一起算上。 见上一节。
需要改配置或代码的
- 加丢失告警或死信通道。 这是我认为真正该修的地方:发送失败时至少让用户看到”答复发送失败,请重发一条消息”。失败已经发生了,静默是设计缺陷,不是运维问题。
- 回合中途发心跳(未验证)。 思路是在回合进行中每隔一段时间发一条进展消息,把通道活性保住。但这只是推测,而且窗口期内的发送尝试可能加重上游的惩罚,必须先做小样本实测再谈推广。
已经存在的可调旋钮(配置路径 platforms.weixin.extra.<key>,或环境变量 WEIXIN_<KEY>):
| 参数 | 作用 | 默认值 |
|---|---|---|
send_chunk_delay_seconds |
长消息分片之间的间隔 | 1.5 |
send_chunk_retries |
分片重试次数 | 4 |
rate_limit_circuit_threshold |
熔断阈值 | 1 |
要强调的是:这些旋钮都救不回已经过窗口的发送,它们只影响失败之后的重试节奏。别指望调参能修好这个问题。
一个反直觉的细节:消息其实没”永久丢失”
看到”丢失 27 次”,很容易理解成 27 条答复永久消失。实际不是。
这套系统在发送之前就把最终答复写进了一个交付台账。用户再发一条消息回来时,台账里的旧答复会被重投:
INFO gateway.run: Redelivered recovered final response to weixin:<PEER> (obligation <OBLIGATION_ID>, attempt 2)
实测 9 月 29 日起共 7 条重投记录,其中 6 条落在 9 月 30 日。当天 27 次彻底失败里,有 6 次在后续被补上了。
重投的真正触发条件是”用户下一条消息”,不是进程重启。 我核了这 7 条记录,每条之前 6 秒到 70 分钟不等都有一条微信 inbound——是那次 inbound 把上一轮的答复顶了出去。7 条里 6 条 attempt=2、1 条 attempt=1。
这个区别很关键,因为它决定了这个兜底有多大用:只有当你主动再发一条消息时,上一条丢失的答复才有机会补上。如果你发完问题就一直在等,什么都不会发生——而恰恰是这种情况最容易被理解成”AI 挂了”。所谓自愈,其实要用户先动一下手。
准确的说法是”静默但可恢复“:用户当时看不到,等用户下一次开口时可能补上。它降低了损失,没解决静默。
通用教训
用户”没回应”要先查日志再查人。 六百多条失败挂在同一位置,查一次就能发现。把”用户没反应”直接理解成”用户在忙”,是排查上的失职,特别是当故障方本来就没给用户任何提示的时候。
别信文档里的数字,自己重算一遍。 这次排查顺带推翻了自家笔记里的三个数字:就绪回合数、间隔分桶数据、还有一个根本不存在的”离群点”(其实是另一个平台的行被误算进来)。根因是那份诊断脚本没做平台过滤,而它自己的注释里写着必须过滤。注释与实现不一致,加上脚本本身还跑不起来。记录下来的结论,如果不带可复现的命令,过几天就变成了不可信的传说。
先找突变日,再谈概率。 概率描述现状,趋势定位引入点。
静默失败要当成一级缺陷。 有日志、有重投台账,但用户侧零感知,这是设计问题。任何”发送失败不影响主流程”的辩解,在用户体验面前都站不住。
上游”修好了”要分清修的是什么。 知道自己错在哪、把错误串改得可读,这叫分类修复;消息真的送到,叫投递修复。前者让排查更快,后者才解决问题。截至我实测的那天,分类已经修了,投递还没有。
附:复现脚本
完整诊断脚本是本次排查最可复用的产出。逻辑不复杂:按平台过滤出微信回合,把「答复就绪」和 5 秒内的「彻底失败」配对,算出每个回合的耗时、间隔,再按间隔分桶。脚本已放到 scripts/diag-weixin-delivery.py:
python3 scripts/diag-weixin-delivery.py 2026-09-30
通过 --log 换日志路径,第一个参数换目标日期。写这类脚本时有两条必须遵守的约束:按平台精确过滤,以及失败判定带时间窗口(发送失败要紧跟就绪日志,不能全局匹配),否则一天里无关的失败行会污染统计。