Hermes Agent 集成 REA MCP:170 个逆向工程工具一步到位
背景:逆向工程不是只有 IDA
做逆向工程的人都知道 IDA Pro:商业授权一年数万元,界面复杂,学习曲线陡峭。Ghidra 免费,但需要自己折腾 Java 环境和插件。把「拆二进制」这件事和 AI 扯上关系,之前更是想都不敢想——AI Agent 连文件都读不全,更别说反编译了。
这个印象在 2026 年 10 月被一个开源项目打破了。
REA(Reverse Engineer Anything)是一个本地 MCP 服务器,把 AI Agent 直接接上逆向分析工具链。它 2026-04-14 创建,6 个月涨到 13 万+ star;10-12 当天单日新增 3.3 万 star(10.3 万 → 13.6 万),冲上 GitHub Trending #1。最新 release 是 rea-agents 6.4.0(2026-10-11)。
和传统方案放一起看,差距很直观:
| 方案 | 成本 | 交互方式 | 证据链 |
|---|---|---|---|
| IDA Pro | 商业授权,数万/年 | GUI 手动 | 无内置 |
| Ghidra | 免费开源 | GUI + 脚本 | 无内置 |
| REA | 免费开源 | Agent 对话 / CLI | 内置 Evidence + Limitations |
我用 Hermes Agent 实测了完整接入流程:170 个工具一次装齐,rea mcp doctor 显示 expected=170 observed=170,全部 healthy。这篇文章记录怎么装、能干什么、以及 3 个最值得提前知道的坑。
是什么:一个 MCP 服务器 + 170 个工具
REA 是本地运行的 MCP 服务器。MCP(Model Context Protocol)是让 AI Agent 调用外部工具的标准协议,Claude Code、Codex、Cursor、Hermes 这些 agent 都支持。装上之后,你在对话里就能直接说「帮我反编译这个 APK」或「看下这个 Electron 应用的 IPC 结构」,REA 返回带证据的结论,而不是猜测。
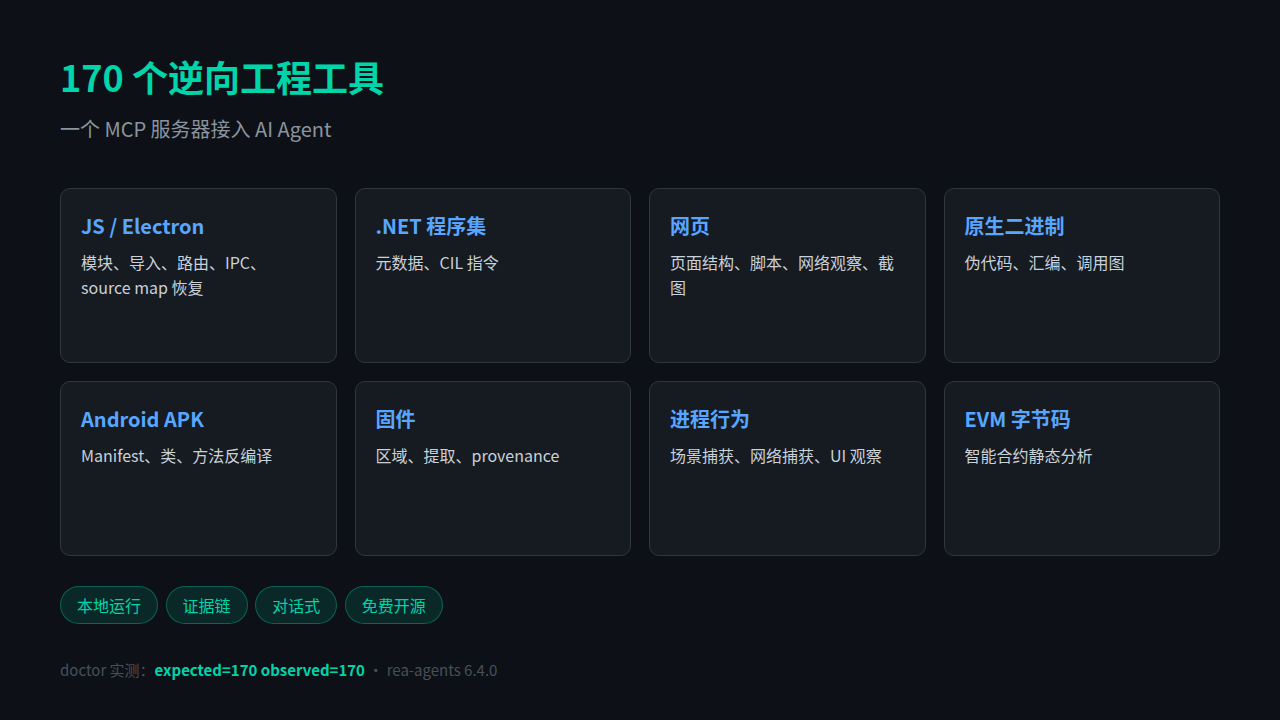
它能分析的东西分两类:
| 目标 | 需要什么 | 说明 |
|---|---|---|
| JS / Electron 应用 | 仅 Node.js | 模块、导入、路由、IPC、source map 恢复,纯静态 |
| .NET 程序集 | 无 | 元数据、CIL 指令,纯静态 |
| 网页 | Chrome 系浏览器 | 页面结构、脚本、网络观察、截图 |
| 原生二进制 | Hopper / Ghidra / IDA 任一 | 伪代码、汇编、调用图,需要逆向引擎 |
| Android APK | JADX + JDK | Manifest、类、方法反编译 |
| 固件 | Binwalk / Unblob | 区域、提取、provenance |
关键设计是「证据链」:每个结论都附原始指令、反编译代码、调用路径,不凭印象给答案。所有分析在本地跑,不上传云端。
怎么用:3 条命令装好
前置要求只有 Node.js ≥ 22.19(我实测 v22.23.2 没问题,npm 12.0.2)。安装三步:
# 1. 全局安装(避免 npx 缓存毒化和启动慢)
npm install -g rea-agents@6.4.0

# 2. 干跑预演,先看它要动哪些文件
rea setup --client hermes --dry-run

# 3. 正式执行
rea setup --client hermes
用 -g 全局装而不是 npx rea,是因为 npx 每次都会先查缓存、装完还要等进程退出,MCP 服务器这种长驻进程用全局安装启动更快也更稳。安装输出 added 144 packages in 11s,CLI 落在 rea 命令。验证:
rea mcp doctor
# healthy: true | tools: expected=170 observed=170 missing=none duplicates=none
之后重启 agent 会话,mcp__rea__* 工具就会出现在工具列表里(我实测当前会话注册了 172 个,170 工具 + 2 个 MCP 内部条目)。
注意 --client hermes 这一步:REA 的 setup 支持一键注册多个 agent,但默认的 --all-detected 会同时改 6 个客户端配置文件(Claude Code、Windsurf、Devin 等),你只想用某一个的话就明确指定 --client,别让它乱动别的配置。
踩坑记录
坑 1:没有逆向引擎也能用大半功能
rea doctor 第一次跑出来 environment_healthy: false——因为我的机器上 Hopper、Ghidra、IDA 一个都没装。这不阻塞安装:JS/Electron 静态重建、.NET 分析、网页捕获、进程行为、EVM 字节码这些路径完全不需要引擎。
需要引擎的只有原生二进制伪代码/反编译。Ghidra 免费但要 JDK 21 + 设置 GHIDRA_INSTALL_DIR;Hopper 和 IDA 是商业软件。APK 反编译要 JADX,固件提取要 Binwalk。我的建议:先装上 MCP + skill 用免费路径,真正需要拆原生二进制时再补 Ghidra。
坑 2:上下文占用 2.1MB,但日常会话不受影响
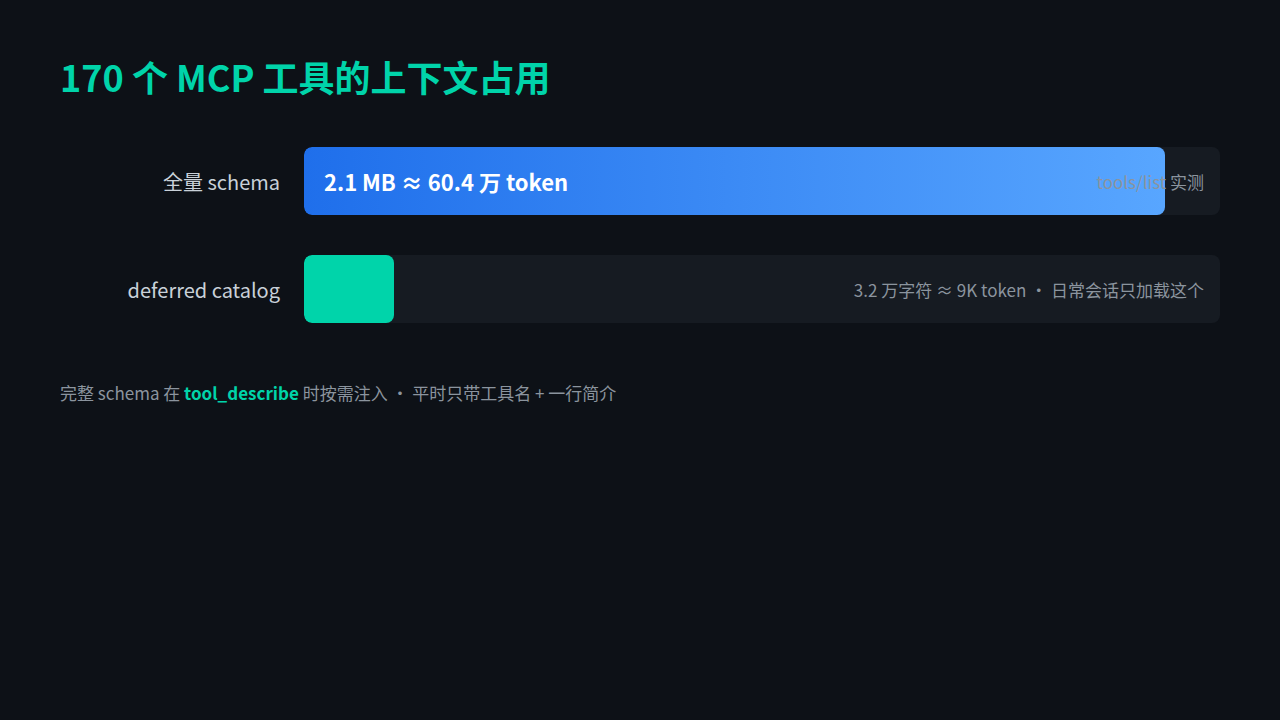
这是我最关心的:170 个工具的全量 JSON schema 有多大?实测 tools/list 返回 2,115,690 字符(2.1MB),约 60.4 万 token,平均每个工具 12,445 字符。如果 agent 启动时全部注入,任何模型都会爆上下文。
实际上 Hermes 用的是 deferred catalog 机制:启动只加载工具名 + 一行简介(129 条 × 约 250 字符 ≈ 3.2 万字符,约 9K token),完整 schema 在你真正要调用某个 REA 工具时才按需注入。所以日常会话里这 60 万 token 不会真的占满,只有干活时才加载对应的那一个 schema。
坑 3:CLI 命令数和 MCP 工具数口径不同
CLI 侧是 129 个命令,MCP 侧是 170 个工具。差异来自 MCP 协议层(prompts 等额外条目),不是装漏了。判断安装是否完整就看 rea mcp doctor 的 expected=170 observed=170,别拿 CLI 命令数对不上号当故障。
总结
REA 把逆向工程的门槛从「几万块授权 + 专业 GUI」拉到了「对话式提问」,而且开源免费。装好之后最直观的变化:我的 agent 现在可以直接对软件包、脚本、APK 提出分析需求,拿回来的结论带证据链,能追到具体的反编译代码和调用路径。
适合三类人:想给 Agent 加逆向能力的开发者、需要快速分析 JS/.NET 应用的运维、以及想低成本入门逆向的爱好者。不想用 Hermes 的话,Claude Code 或 Codex 同样支持——安装命令只有 --client 参数不同。
如果你也装了,建议从 rea doctor 开始,先看自己的环境缺哪些引擎,再决定要不要补 Ghidra 那条免费路径。