先说结论
给 Docker 容器换机器,第一步不是打包拷贝整个数据目录,而是先算清楚:哪部分是持久配置,哪部分是可以重新生成的缓存。
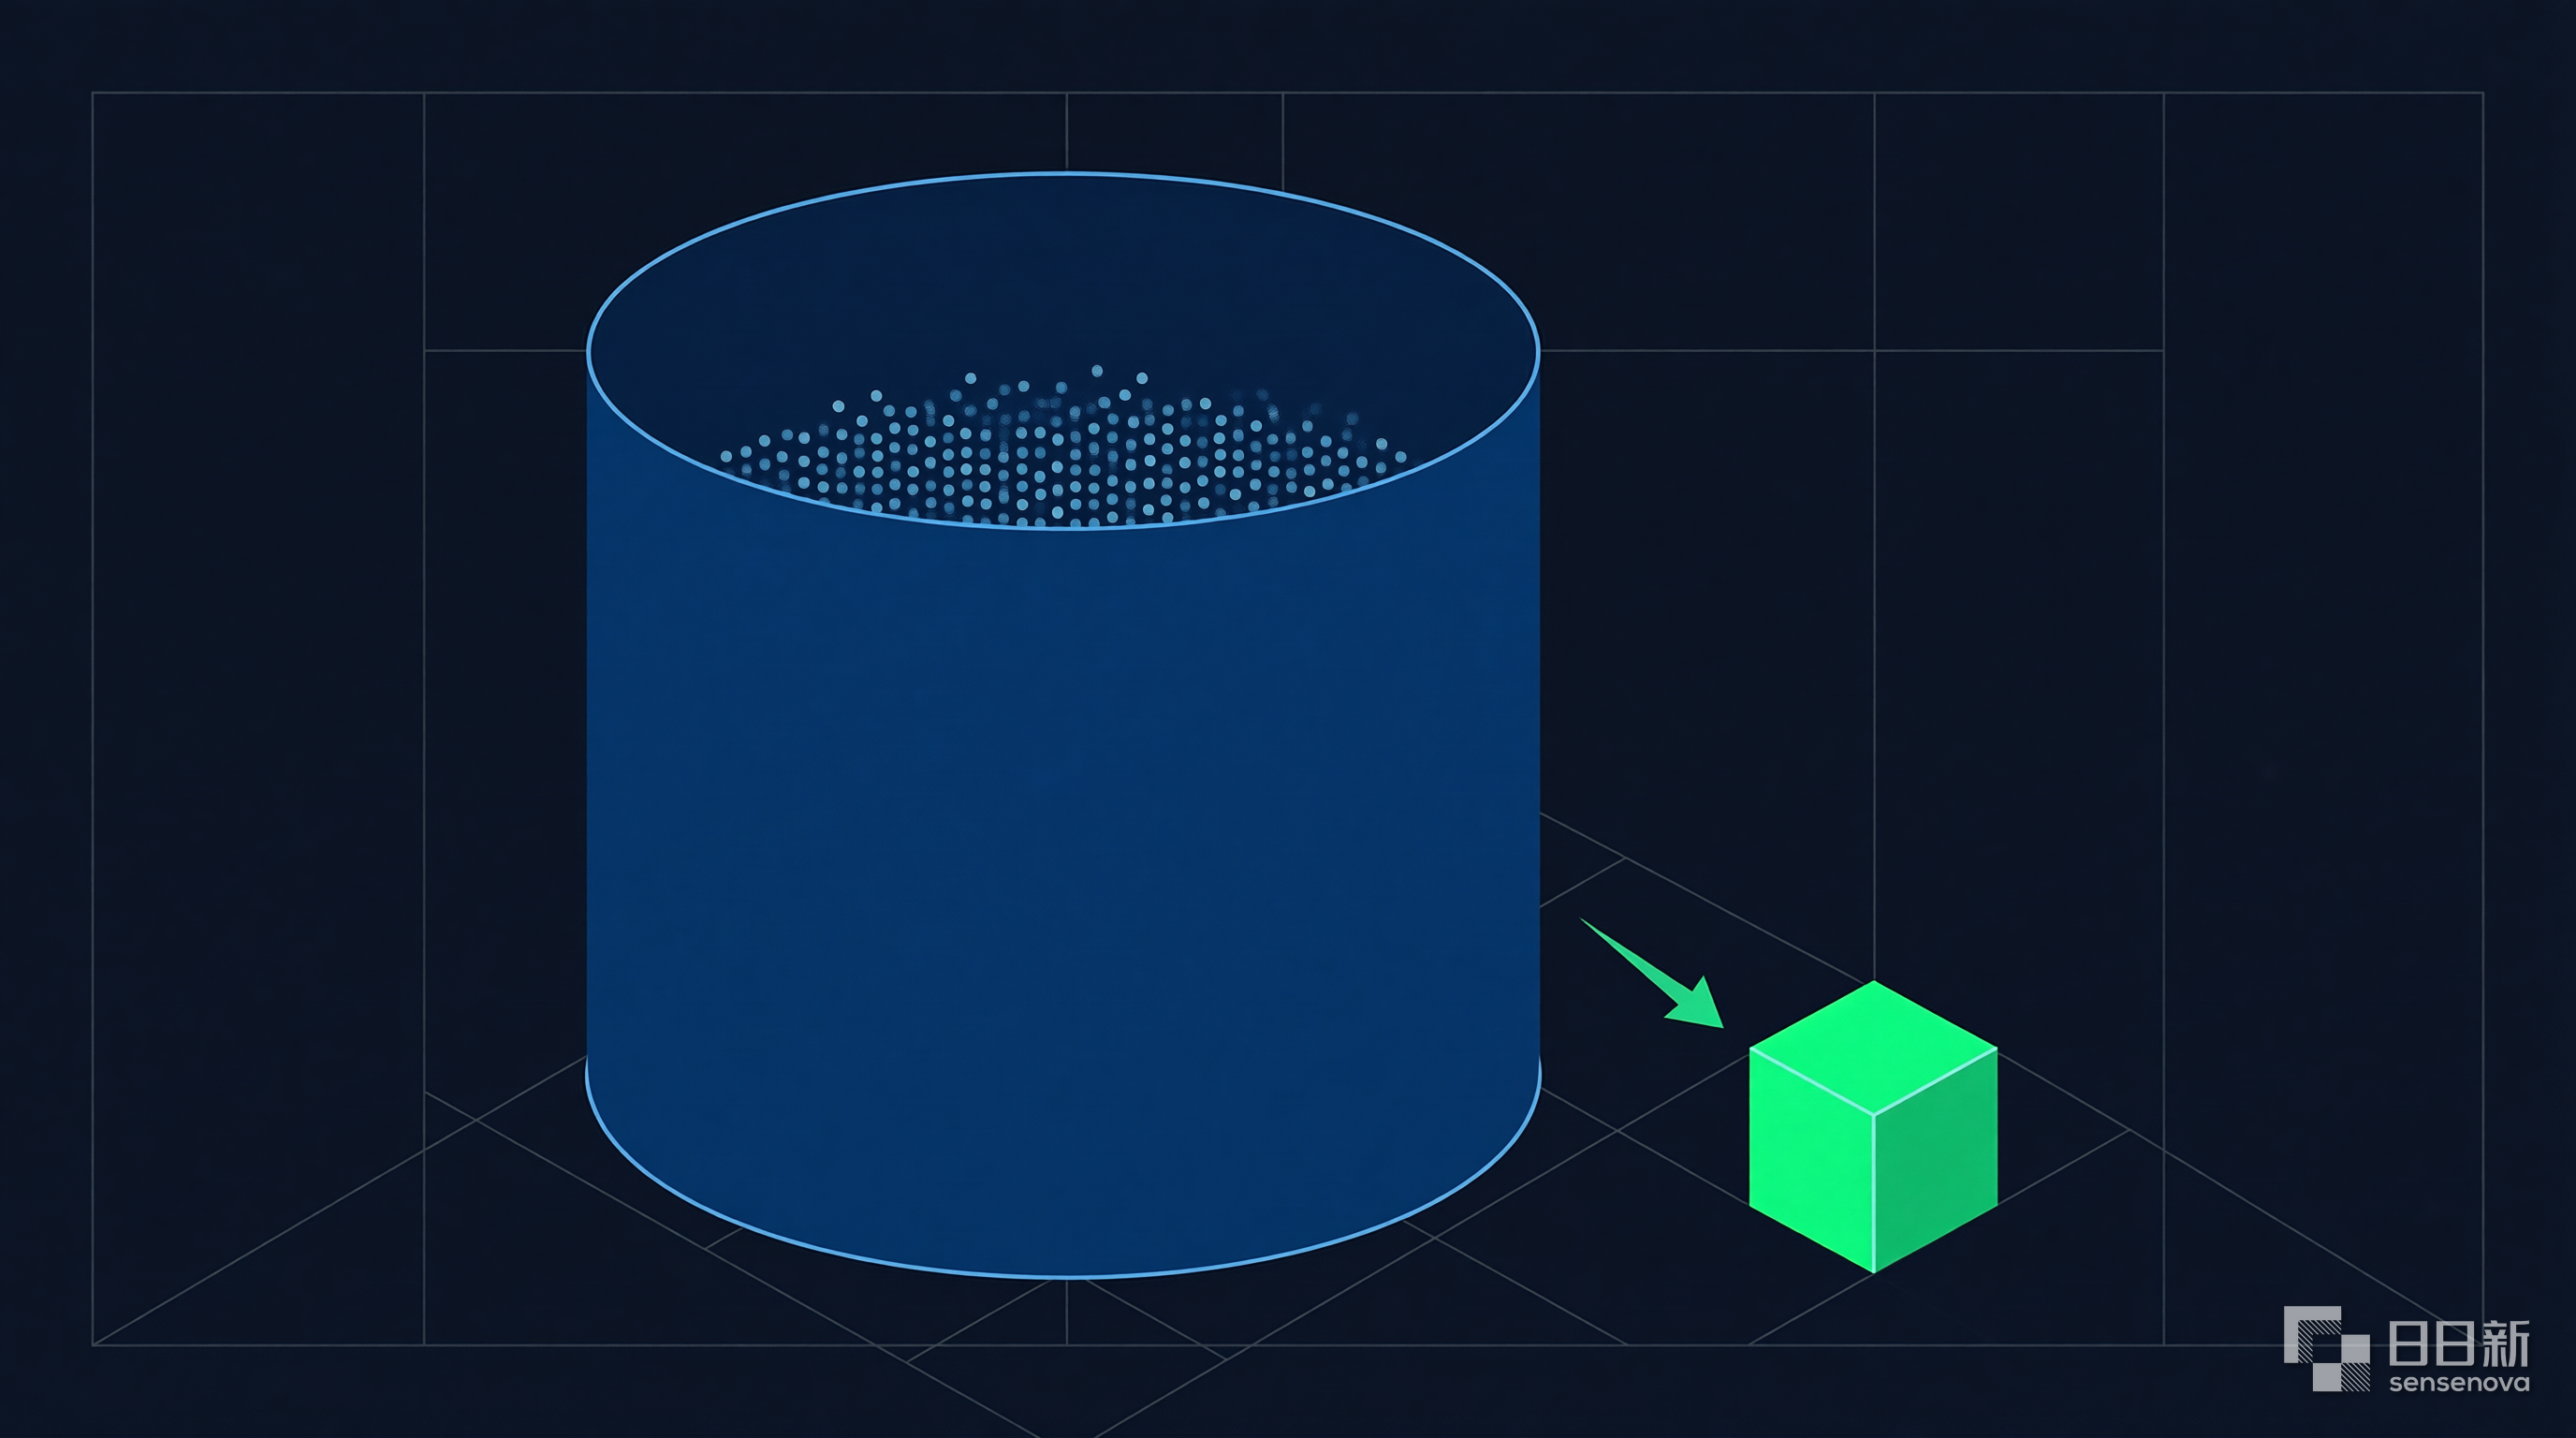
我这次迁 ESPHome 容器,旧机数据目录整整 3.3G,最后只搬了 504K。剩下的 99.98% 是编译缓存和工具链,新机器上跑一次编译就自动重建,搬过去纯属浪费时间。
背景:服务器要换,容器要重建
我的 ESPHome 容器跑在一台老服务器上,后来容器停了,但数据目录一直在。最近换了台新 NAS,需要把这套设备管理(3 个传感器设备的固件配置)在新的 Docker 环境里重建起来。
大多数人的第一反应是把整个数据目录原样拷过去。3.3G 不算大,但对内网传输、备份来说都是负担。而且我隐约记得 ESPHome 的配置其实就是几个 yaml 文件,不至于有 3G 那么多——那一大坨到底是什么?
先拆解:du 一量就明白了
动手之前先看目录里都有什么:
# 查看数据目录结构
find /path/to/esphome -maxdepth 3
# → esp32d1.yaml / esp32devk1.yaml / esp32c3.yaml / secrets.yaml
#   images/(设备图标)
#   fonts/(像素字体)
#   .esphome/(编译缓存)
#   .platformio/(PlatformIO 工具链)
结构很清晰:设备配置是几个 yaml,外加字体和图标资源。剩下两个隐藏目录 .esphome/ 和 .platformio/ 看起来可疑——它们才是体积大头。
量一下总大小:
du -sh /path/to/esphome
# → 3.3G

# 排除编译缓存和工具链再看
du -sh /path/to/esphome --exclude=.esphome --exclude=.platformio
# → 504K
3.3G 对 504K。也就是说,99.98% 的数据是 .esphome/(编译产物)和 .platformio/(PlatformIO 工具链),这两样在新机器上跑一次编译就会自动重建,属于可再生缓存。真正需要带走的持久配置,只有 504K。
这也是官方文档明确的:.esphome/ 就是缓存目录,可选、可重建。
只搬配置:一条 tar 管道搞定
确认了该搬什么,剩下的就是怎么搬。目标:只打包持久配置,排除缓存,跨机器直接传输。
# 源机器上打包(排除缓存),通过 SSH 管道在目标机器解包
ssh user@new-nas \
  "ssh user@old-server 'cd /path/to/esphome && tar czf - --exclude=.esphome --exclude=.platformio .' \
   | tar xzf - -C /path/to/esphome"
这条命令的关键是 tar czf -:把压缩包写到 stdout,不走中间文件。SSH 管道把它直接喂给目标机器的 tar xzf -,一次性完成打包、传输、解包三个动作。
解完验证一下:
ls -la /path/to/esphome/    # yaml/fonts/images/secrets 齐全
du -sh /path/to/esphome     # 504K
传输量从 3.3G 降到 504K,耗时从分钟级降到几秒。
重建容器:docker run 与 docker compose 二选一
docker run 方式
我这边环境比较老,习惯用 docker run:
docker run -d --name esphome \
  --restart unless-stopped \
  -v /path/to/esphome:/config \
  -v /etc/localtime:/etc/localtime:ro \
  -e TZ=Asia/Shanghai \
  -p 6052:6052 \
  -p 6053:6053 \
  esphome/esphome:latest
| 参数 | 说明 |
|---|---|
-v .../esphome:/config |
配置目录挂载(官方镜像约定 /config) |
-p 6052:6052 |
Dashboard Web UI |
-p 6053:6053 |
ESPHome API(设备接入) |
--restart unless-stopped |
重启策略 |
-e TZ=Asia/Shanghai + localtime 挂载 |
时区 |
docker compose 方式(官方推荐)
新环境建议用 compose,配置更清晰、可版本管理:
services:
  esphome:
    container_name: esphome
    image: ghcr.io/esphome/esphome
    volumes:
      - /path/to/esphome/config:/config
      - /etc/localtime:/etc/localtime:ro
    restart: always
    privileged: true
    network_mode: host
    environment:
      - ESPHOME_USERNAME=admin
      - ESPHOME_PASSWORD=ChangeMe
注意:
network_mode: host在 macOS 上不生效,macOS 用户用-p 6052:6052端口映射方式。
验证:启动 5 分钟,设备全部自动回来
容器起来后看健康状态和日志:
docker ps --filter name=esphome --format '{{.Names}} {{.Status}}'
# → esphome Up 58 seconds (healthy)

docker logs esphome 2>&1 | tail -20
# → Devices controller started — 3 devices loaded
# → MQTT discovery starting — broker=192.168.x.x:1883
# → MQTT connected to 192.168.x.x:1883
# → ESPHome CLI sanity check OK — Version: 2026.8.1
3 个设备配置被新 Dashboard 自动识别,MQTT 自动连回原来的 broker。从拉镜像到设备全部恢复,全程约 5 分钟。
踩坑记录
这次迁移踩了几个坑,写出来帮你避雷。
坑 1:容器内 ls 报 “No such file or directory” 以为是挂载问题
docker exec esphome ls /config/*.yaml
# → No such file or directory
第一反应是挂载失败了。实际上文件都在,问题出在 shell 通配符:/config/*.yaml 在容器内没有被展开,glob 失败导致报错,根本不是挂载问题。
验证方法很简单,用不带通配符的命令:
docker exec esphome ls -la /config/
文件都在。别被一条报错吓到,先想想是不是 shell 展开的问题。
坑 2:老设备静态 IP 冲突
迁移时顺带发现一个历史遗留问题:两个设备都配了同一个静态 IP(.220)。ESPHome 固件里用 manual_ip 指定了固定地址,两个设备抢一个 IP,只有其中一个能正常通信。
处理:改其中一个 yaml 的 manual_ip,重新编译烧录。
坑 3:新版 Dashboard 端口习惯变了
网上老教程基本只提 6052 一个端口。ESPHome 2026.x 新版默认 6052 Dashboard + 6055 remote-build peer-link(远程构建通道)。映射 6052/6053 就够日常使用,6055 按需。
坑 4:config 卷用 NFS 挂载可能冻结
如果配置目录是挂在 NFS 共享上的,PlatformIO 在 NFS 上运行可能因为文件锁问题直接冻结(官方 issue platformio-core#3089)。官方建议 NFS 卷加 nolock 挂载选项。我这次用的本地盘,没遇到,但如果你是 NFS 用户要先处理这个。
方法论:这套思路适用任何 Docker 容器
这次迁移的本质不是”ESPHome 怎么装”,而是一套通用的容器迁移瘦身方法论:
- 先拆解:
du -sh看目录里每部分占多大 - 分类:区分”持久配置”(yaml、数据库、上传的文件)和”可再生缓存”(编译产物、node_modules、pip 缓存、模型缓存)
- 只搬前者:
tar --exclude或 rsync 排除缓存目录 - 重建后验证:启动看日志,确认服务正常、数据完整
这套思路对几乎任何 Docker 容器都成立。Node 项目的 node_modules、Python 项目的 venv/pip 缓存、构建工具的产物目录——全都是可再生资源,迁移时不用背着走。真正需要搬的,往往只有几百 KB 到几 MB 的配置和数据。
下次给容器换机器,别急着整目录拷贝。先 du 一下,你可能只用搬 0.02%。