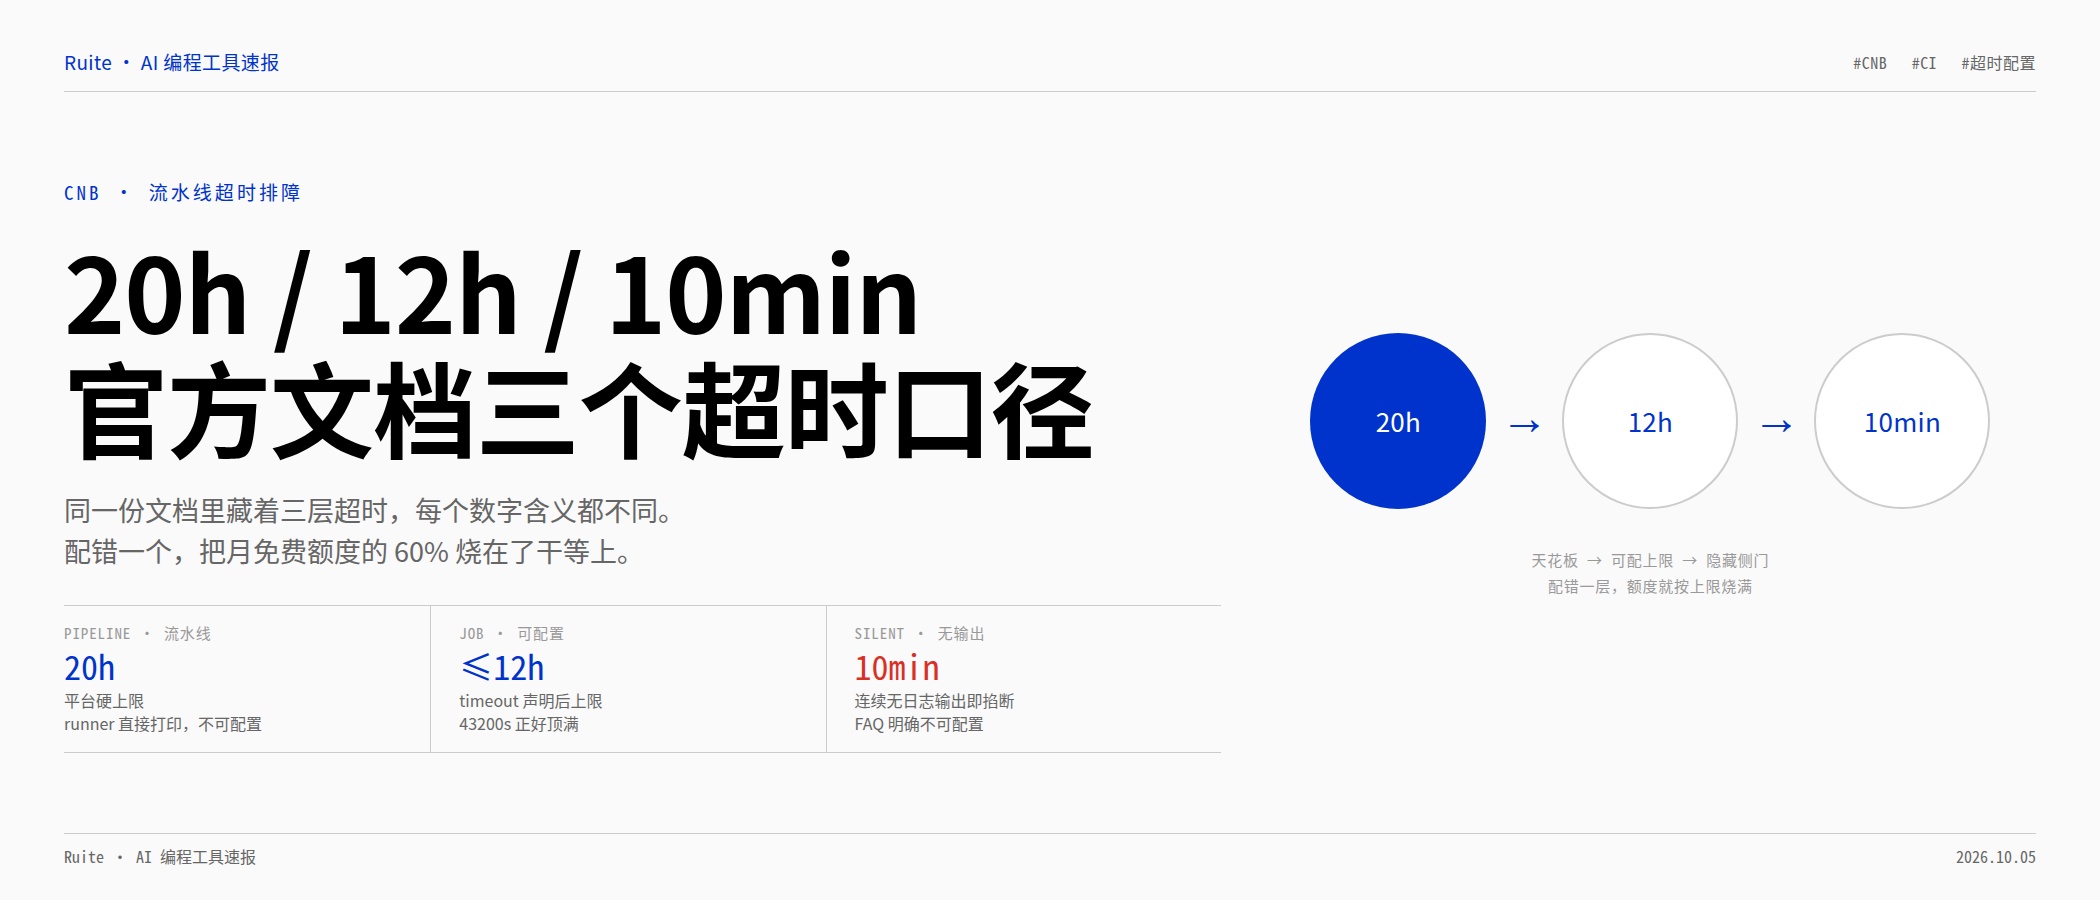
给视频处理流水线做 CI 排障那天,我先后三次撞上”超时”这个词,每次含义都不同。第一次在官方 timeout 文档里读到”流水线最长 20 小时”,第二次在项目配置里看到别人写的 timeout: 43200s(12 小时),第三次从报错日志里翻出”连续 10 分钟无输出将触发超时”。
三处口径,三个数字。而我的流水线恰恰因为其中一处,把月免费额度的 60% 烧在了干等上。
这篇把三处口径的关系讲清楚,附上我踩过的坑和最终的四层对齐方案。
背景:一条会”跑满配置上限”的流水线
我的场景是一条视频处理流水线:本地 NAS 上传视频 → 云端跑 VAD+YOLO 智能截取 → 归档回本地。云端按核时计费,免费额度分两档:云原生开发(workspace)1600 核时/月,云原生构建(build)160 核时/月。8 核节点跑 1 小时就是 8 核时。
9 月额度烧得异常快。查 workspace/list 才发现:流水线以 workspace 形式跑了 20 次,平均 9.75 小时,20 × 9.75 × 8 ≈ 1560 核时——几乎精确等于 1600 核时的开发月额度。后来触发方式切到构建路径,额度一下子缩到 160 核时/月,只剩原来的 1/10。
不是”空转”烧的,是跑满配置上限烧的。罪魁就是配置里的 timeout: 43200s。
三处口径,三个数字
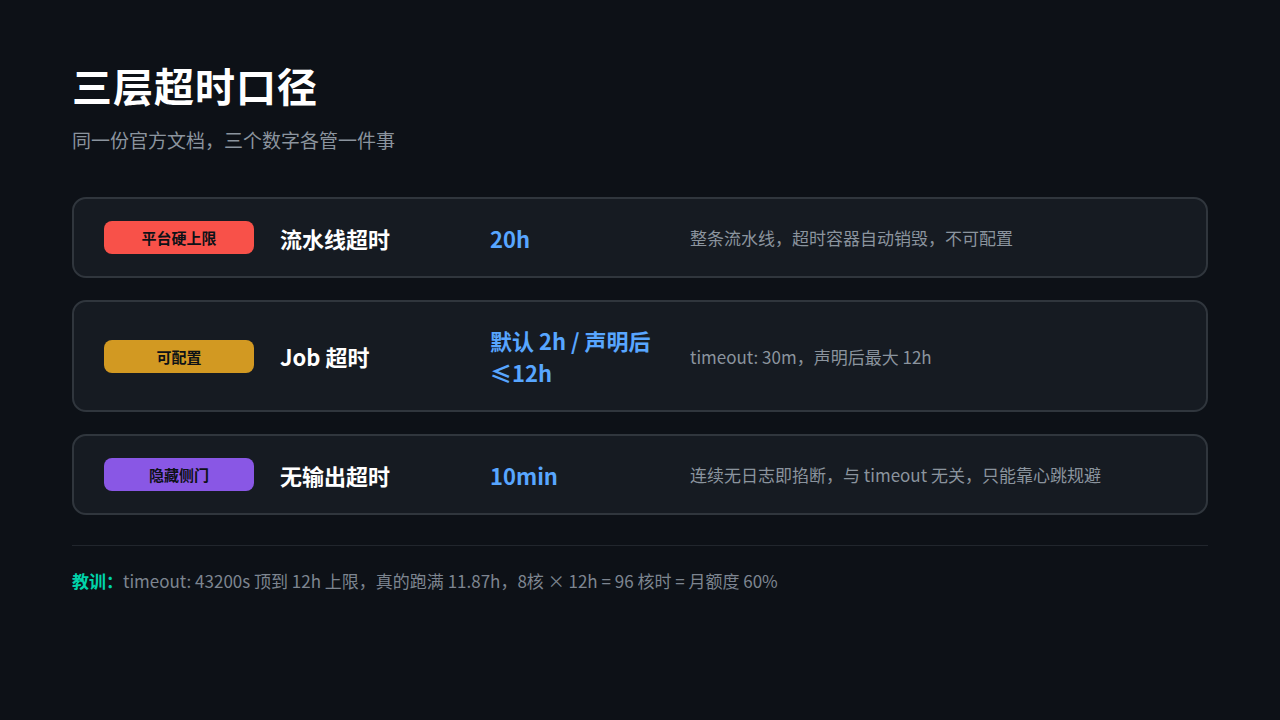
官方 timeout 文档里其实藏着三层完全不同的超时:
| 口径 | 数值 | 触发条件 | 能否配置 |
|---|---|---|---|
| 流水线超时 | 20h | 整条流水线超时 | ❌ 平台硬上限 |
| Job 超时 | 默认 2h / 声明后 ≤12h | Job 累计执行超时 | ✅ timeout: |
| 无输出超时 | 默认 10min(声明后=配置值) | 连续无日志输出 | ⚠️ 只能靠持续输出规避 |
第一层”流水线 20 小时”是平台硬上限,runner 日志里直接打印 maxPipelineRunTime: 20h,不可配置。
第二层才是配置项。语法是 timeout: 30m(支持 ms/s/m/h 单位),默认 2 小时,声明后最大不超过 12 小时。我项目里的 43200s 正好顶到 12 小时上限。
第三层最隐蔽:Job 连续 10 分钟无任何输出就触发超时,跟 timeout 配置无关,FAQ 明确说不能通过配置修改。长任务只要 10 分钟不打印日志就会被掐断。
我踩的坑:12 小时空等
timeout: 43200s 是能生效的——平台允许最大 12 小时,配置就真的按 12 小时执行。实测每个 workspace 跑满 11.87 小时,8 核 × 12h = 96 核时。在开发额度(1600 核时/月)下这只是零头,但触发方式切到构建路径后,一次 12 小时空等就是构建月额度(160 核时)的 60%——烧穿只差一次。
这里有个反直觉点:超时参数不是”写进 yml 就完事”,它会真实执行,而且按配置上限烧满额度。平台没出 bug,是我把上限用满了。
更隐蔽的是无输出超时。流水线的主处理循环里有长时间无日志的段,10 分钟一到就被平台掐断。解决方法是加一个 30 秒心跳线程,持续打印处理进度,实测有效。
配额那边还有一个”无余量”的坑
超时之外,配额接口还有个单位陷阱:charge/quota 返回的 ci_in_sec 是核秒,不是核时。直接当核时用会差 3600 倍,÷3600 才是核时。
还有一件容易误判的事是”启动失败”。有次构建 7 秒就 error,我以为功能坏了。实际是预冻结机制:启动后每 5 分钟冻结一次用量,冻结量 = 5 分钟 × 节点规格(8 核 = 0.67 核时/次)。预冻结时可用额度不足,任务立即终止,连排队的机会都没有。这是额度耗尽的表现,不是故障。失败本身很便宜,prepare 阶段就 error,没过预冻结不计费。
还有月底清零:免费额度月底归零、不叠加至次月。额度耗尽后等次月即可,不用付费救急。
四层超时对齐方案
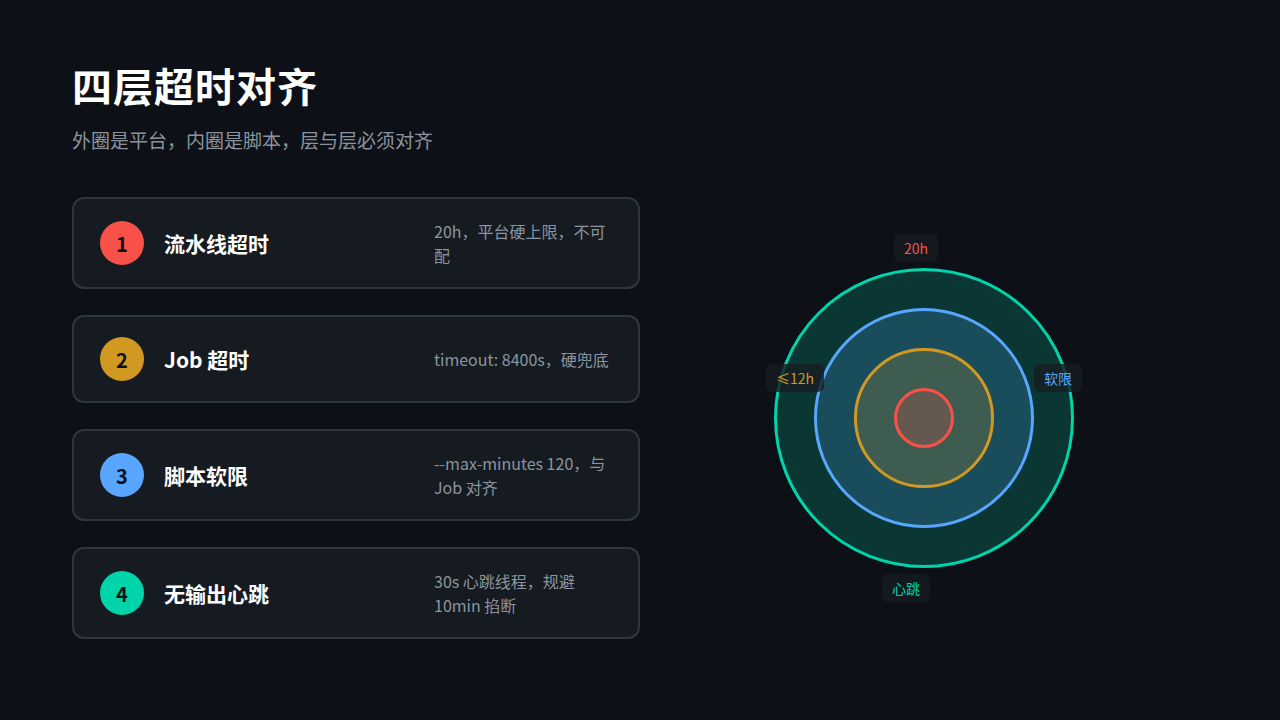
排障最终收敛成一套”四层对齐”:
流水线 20h(平台硬上限,不可配)
  > Job timeout(可配,≤12h)
  > 脚本软限(--max-minutes)
  > 无输出心跳(30s 持续输出,规避 10min 掐断)
我的最终配置:
timeout: 8400s(2.33 小时硬兜底,对齐脚本软限)--timeout 0(空池即退,不再干等)--max-minutes 120(脚本自身 2 小时软限)
关键是把 Job timeout 和脚本软限对齐:脚本挂住时烧满 stage 时长(8400s × 8 核 = 16 核时/路),两层不匹配会白白烧额度。
排查顺序(可直接照抄)
- 先读官方 timeout 文档,把三层口径装进脑子(1 分钟)
- 查配额:
GET /{org}/-/charge/quota,核秒 ÷3600 = 核时 - 查在途冻结:
GET /{org}/-/charge/volume,看freeze_*字段 - 读 runner 日志确认平台实测值:找
maxPipelineRunTime: 20h、配额大小、CPU/内存 - 对齐四层超时(上面那张图)
- 验证触发路径:构建接口的
sync参数必须是字符串"false",布尔值会报 400
总结
三处超时口径的关系一句话说清:流水线 20h 是天花板,Job timeout 是你能配的(≤12h),无输出 10min 是隐藏的侧门。真正烧额度的是”配置允许 + 任务真的跑满”,以及”脚本软限和 Job timeout 不匹配”。
超时参数一定会被执行,写进去之前先想清楚:这个值如果被跑满,成本是多少?我当时没想到 12 小时 × 8 核 = 96 核时是什么概念,现在记住了。
配额那边的教训同样直接:单位(核秒 vs 核时)、机制(5 分钟阶梯冻结 vs 连续消耗)、时间(月底清零)三个认知对齐之后,”额度怎么没了”这种问题基本不会再出现。