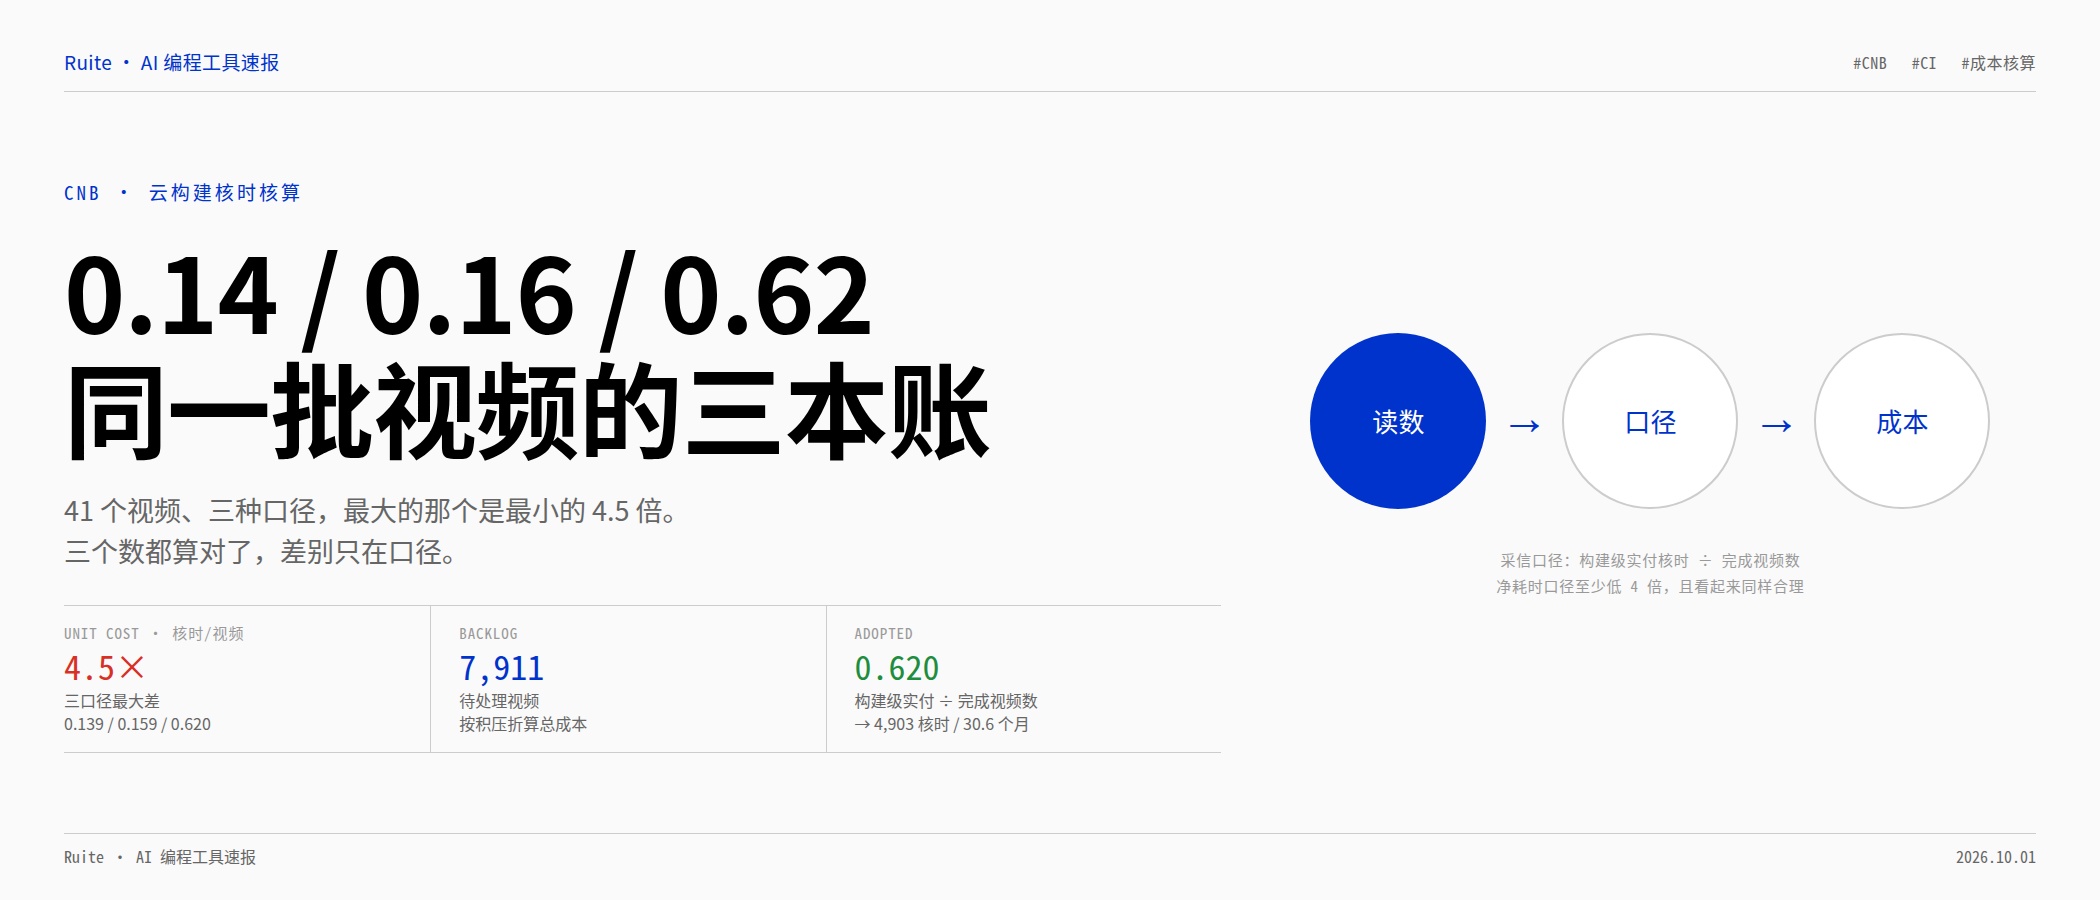
我给自己的一条视频处理流水线算核时成本。同一批数据,前后得出过三个单位成本:0.139、0.159、0.620 核时/视频。最大的那个是最小的 4.5 倍,而最该采信的两种口径之间差 3.9 倍。
三个数都算对了,差别只在我每次用的口径不同,而这三个口径看起来一样合理。
排查过程中还冒出四个”事故”,每一个我都报了警,事后证明问题不存在。根因不在算术,在于我读的信号会滞后、结构上不填充、或者单位对不上。
这篇把两件事讲清楚:核时到底怎么算,以及哪四个信号不能信。
先立规矩:核时 = 分配核数 × 墙钟
平台文档写得很直白:
8核 使用 1小时 = 8核 × 1小时 = 8核时
从这一行能立刻推出三条,每一条都跟直觉相反。
第一,核时跟 CPU 利用率没有关系。8 核任务里哪怕只有 2 核在干活,账还是按 8 核结。所以”利用率低就是浪费”的直觉在这里不成立。真实浪费藏在别处。
第二,降配不省钱。核数减半,墙钟近乎翻倍,乘积不变。降配只在”任务是内存瓶颈、加核没用”这种情况下才有意义。
第三,月底清零。免费额度是 160 核时/月,用不完不结转到下月。剩余额度是到期作废的库存,不是资产。
还有一条计费机制值得单独说:每 5 分钟冻结一次用量,冻结量 = 节点规格 × 5 分钟。8 核就是 0.67 核时。如果预冻结时可用额度不足,任务会被立即终止,连排队的机会都没有。
三个口径,同一批数据
数据来自两个已结算的构建,配置完全相同:
| 构建 | 时长 | 实付核时 | 完成视频 | 单位成本 | 备注 |
|---|---|---|---|---|---|
| b1 | 120.3 min | 16.04 | 19 | 0.844 | 撞上 120 分钟上限被掐 |
| b2 | 70.3 min | 9.37 | 22 | 0.426 | 自然跑完分片 |
| 合计 | 25.41 | 41 | 0.620 |
这是口径 B,构建级实付:核时直接取构建的实际时长乘核数,跟账单同源。
第二个数是 0.159,来自流水线自身的净耗时统计:
| 口径 | 公式 | 算出来 | 能不能进决策 |
|---|---|---|---|
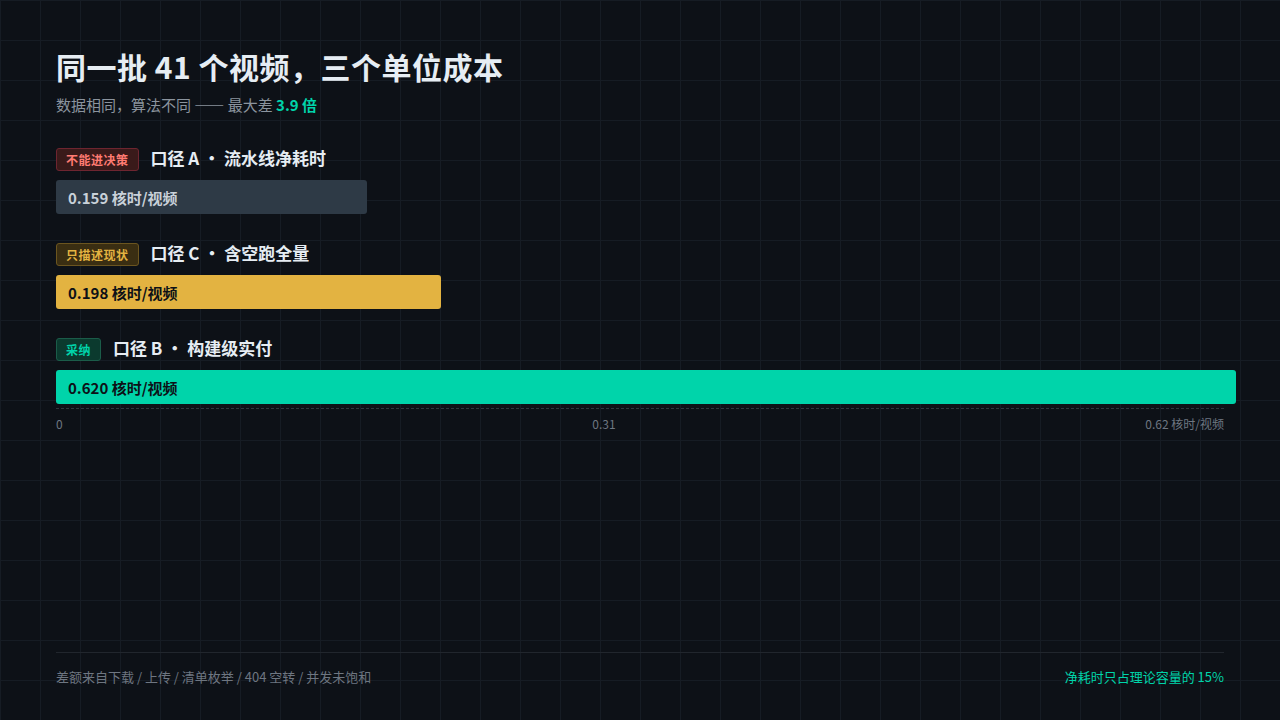
| A 流水线净耗时 | Σ流水线净耗时 ÷ 完成视频数 | 0.159 | 不能 |
| B 构建级实付 | Σ(构建时长 × 核数) ÷ 完成视频数 | 0.620 | 采纳 |
| C 含空跑全量 | Σ全部构建实付 ÷ 完成视频数 | 0.198 | 只描述现状 |
差距来自哪里:两路流水线的净耗时合计 6671 秒,也就是 1.85 小时。而这两路的理论容量是 12.7 小时(2 路 × 2 worker × 各自的墙钟)。净耗时只占容量的 15%,剩下的都在下载、上传、清单枚举、404 空转、并发没吃饱上面。
那句”0.139”更值得说。它出自三路并行构建里完成数最多的那一路,是同一个 1503 秒读数下最好看的一个数字。但它有个致命前提:1503 秒不是完成时长,而是快照 age。同一时刻再查,那个构建还是 status=pending duration=2068s,它还在跑。分母是中途值,分子被低估,两个方向都不干净。
所以口径 A 严格说不是”乐观口径”,是错误口径。它只能用来顺手瞄一眼量级。
结论很朴素:报成本一律用构建级实付核时 ÷ 完成视频数。用净耗时算出来的数字至少低 4 倍,而且看上去非常合理,不容易被怀疑。
按积压 7911 个视频算,两个口径的差距是实打实的:
| 口径 | 单位成本 | 总核时 | 折合免费额度 | 按 ¥0.125/核时 |
|---|---|---|---|---|
| 净耗时 | 0.159 | 1,258 | 7.9 个月 | ¥157 |
| 构建级实付 | 0.620 | 4,903 | 30.6 个月 | ¥613 |
同样的活,一个是 8 个月能消化,另一个要 30 个月。
四个假警报
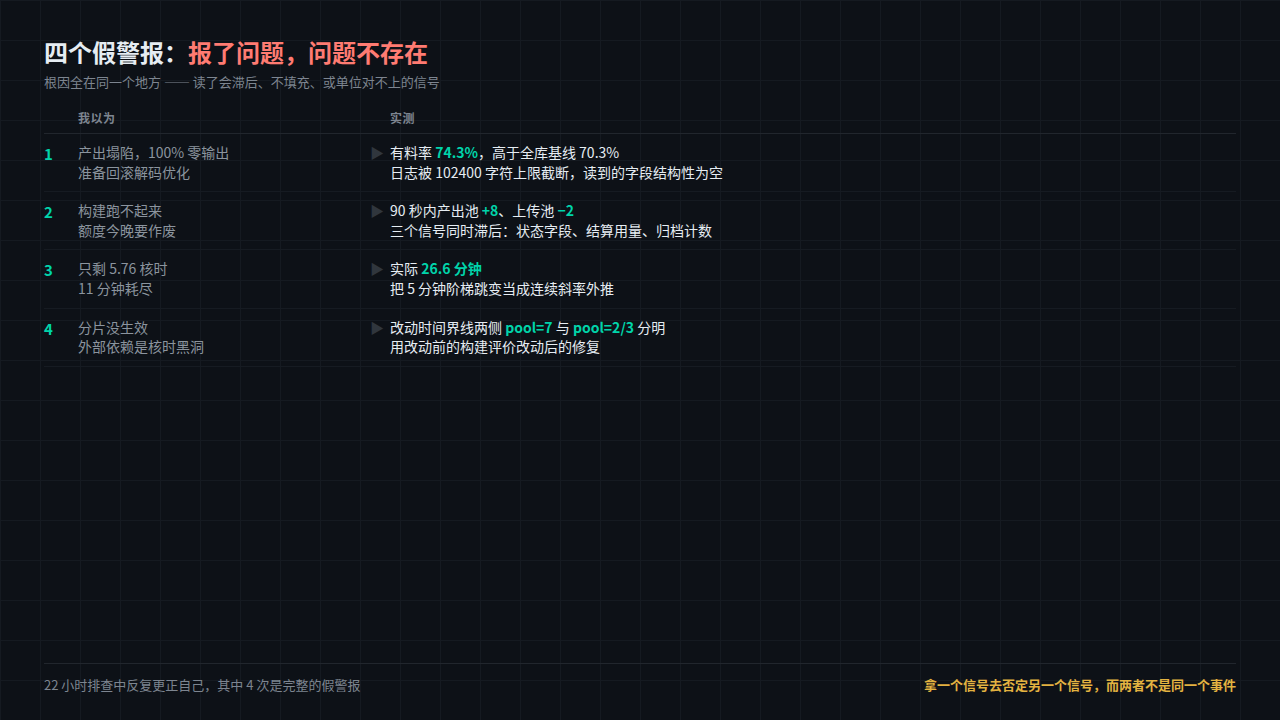
这四个是我在 22 小时的排查里真正踩到的。它们的结构完全一样:我以为 → 实测读数 → 信号为什么骗人 → 正确判据。
① “产出塌陷,今天 100% 零输出”
我读了构建日志,完成标记全是零输出,当场准备回滚刚做的解码优化。
实测:当天归档 335 个,其中正常批次的有料率 74.3%,全库历史基线 70.3%。74.3% > 70.3%,质量没塌。
三条原因叠在一起:CNB 单阶段日志有 102400 字符上限,日志自己会打印 The log length exceeds the limit(102400),而我只读了前 2500 行,恰好是队列里最安静的一批;同时 clip_count 这类字段对已上传状态的行根本不填,125 条全是 0 或 None,属于结构性空字段;再加上那批源本来就是安静期,历史有料率从 18.5% 一路降到 5.9%,趋势早就存在。
判产出量要用数据库或产出池的文件计数,日志只用来读单条记录的过程。
② “构建跑不起来,额度今晚作废”
连续三轮报这个。实际上 90 秒间隔采样两次,产出池 +8、上传池 -2,在处理、在产出、在删源,一切正常。
骗到我的是三个都会滞后的信号同时读:构建的 status 字段长期停在 pending;用量字段要等结算才跳;数据库的归档计数是半小时一轮的独立任务。三个一起滞后,看起来就像卡死了。
判活的唯一可靠信号是池文件数的增量,间隔 60 到 90 秒采样两次。
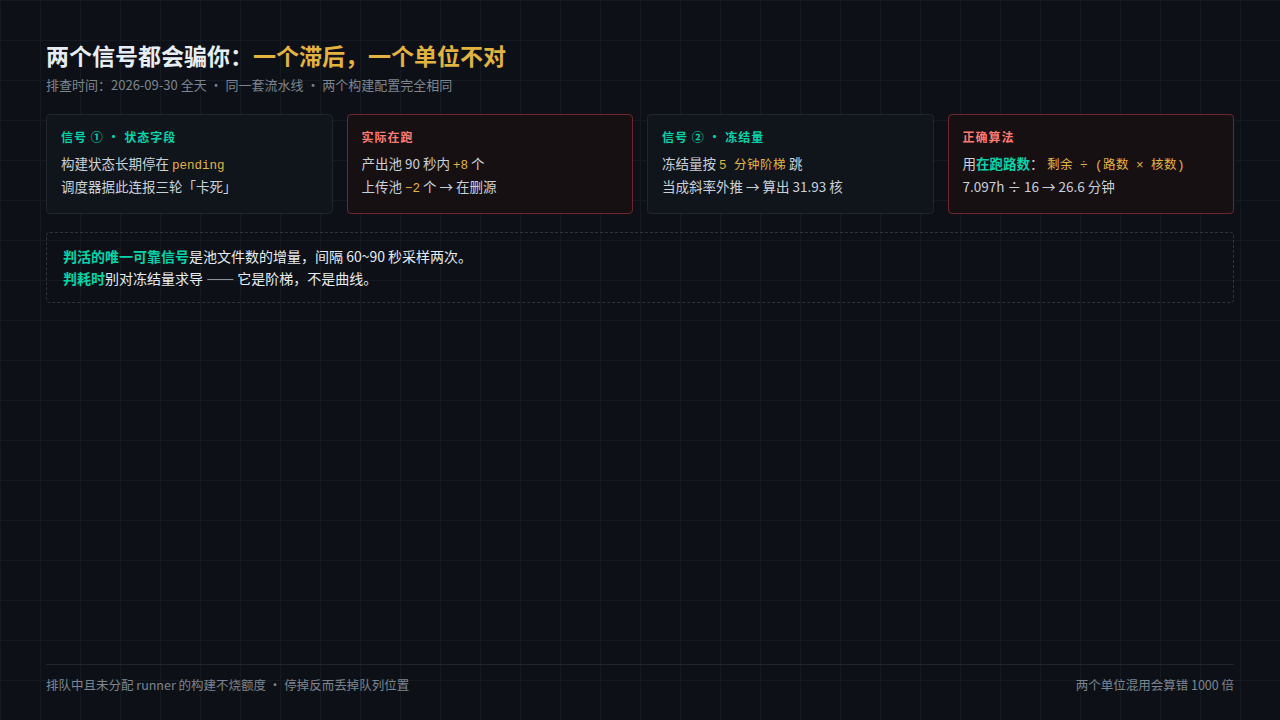
附带一个反直觉事实:pending 且还没分配 runner 的构建不烧额度。所以”排队很久”本身不是损失,停掉反而丢掉队列位置。
③ “11 分钟耗尽”
我看到冻结量在 90 秒内涨了 1.33 核时,当成斜率往外汇,算出 31.93 核的瞬时功率,报”11 分钟耗尽”。
冻结量是按 5 分钟阶梯跳的,不是连续消耗曲线。 90 秒内看到的 +1.33 就是两路各跳一格:8 核 × 5 分钟 × 2 路。
正确算法用在跑路数:剩余 ÷ (在跑路数 × 核数)。当时是 7.097h ÷ (2 × 8) = 26.6 分钟,跟实际被终止的时间吻合。
④ “分片失效” / “外部依赖拖慢处理”
我以为两件事坏了:静态分片没生效导致多路重复处理全量;外部认领服务失效,每个视频一次慢查询,是核时黑洞。
实测第一个:扫描 15 个构建,分界线干净得刺眼:改动时间之前 12 个全部 pool=7 源=287,之后 3 个 pool=2/3 源=100/81。修复生效了。
第二个:实测认领失败时的耗时是 0.061s / 0.021s / 0.349s,287 个视频合计几秒。可忽略。
错误在于我用改动前的构建去评价改动后的修复,时间边界没对齐;以及用”感觉慢”代替”量一下慢多少”。
评价一个修复是否生效,按改动时间把构建列表切开,比读代码快得多。上下各扫一批,分界线自己会浮出来。
还有一个不算警报的坑
构建状态里嵌套的 stages[].status 对 API 触发的构建恒为 start、duration 恒为 0。我据此把两个正常跑完的构建误报成”卡在 start 45 分钟”。
判真实进度只认 pipeline.duration 和平台给出的核时字段。
“总量大于免费额度”不等于绑了预算
额度接口返回两个字段,容易误读:
ci :  total = 4262400 秒 (1184 核时)   free = 576000 秒 (160 核时)
dev:  total = 9446400 秒 (2624 核时)   free = 5760000 秒 (1600 核时)
total 明显大于 free,第一反应是”绑了云预算,额度耗尽要扣真钱”。拆开看:
ci  total (1184) = free (160)  + special (1024)
dev total (2624) = free (1600) + special (1024)
两项都精确吻合。那个 special 是平台发的限时特权,有自己的描述字段和到期时间,跟预算没关系。
判定方法是一次调用,不是猜:
total恰好等于免费额度 → 没绑预算,剩余额度可以放心烧干净total明显大于免费额度 → 再查一次特权接口,看描述字段有没有值、有没有到期时间。有值就是特权,没值才是预算
顺便记两个不存在的端点:仓库级的配额和用量接口都是 404,传组织名就行,别往仓库粒度找。
差 0.12 核时会导致启动失败
有次构建死活起不来,报的是:
Root Group's workspaces CPU core-hours are insufficient for pre-freezing
(Freezing time: 5.00 min, equivalent to 0.67 core-hours)
换算很简单:预冻结量 = 分配核数 × 5 ÷ 60,8 核就是 0.67 核时。当时云原生开发那一档剩余 0.55,差 0.12。
这不是 bug,是额度耗尽。 我一开始连续两轮把它当成”路径已废弃、配置写错了”来推断,直到读了 prepare 阶段的日志原文才定位。
失败也便宜:prepare 阶段就 error,没通过预冻结就不计费。所以”起一个构建看报错”是安全的诊断手段,不用怕烧额度。
日志里还有一行 Free CPU workspace limit: 6,那是免费档的并发上限,跟额度不是一回事。
烧剩余额度的顺序
额度月底清零,剩余就是到期库存。但”把额度用掉”这件事本身不产生价值,按这个顺序来:
先确认触发任务还开着。 剩余额度闲置最常见的原因与额度本身无关:触发任务被停用了。我遇到过池里有 146 个视频待处理、0 个构建在跑的情况,原因就是任务被禁用。
再算清能跑多久。 剩余核时 ÷ 核数 = 一条连续跑道的小时数,跟”距月底还有几小时”比。两者接近,一条跑满正好;剩余时间远大于这个数,就是烧不完,别硬撑。
并发路数的真正上限在供料,不在额度。 静态分片按索引取 upload_shas[i::count]:池里只有 3 个 commit 时,第 4 路拿不到分片直接跳过。更常见的是 upload_commits 里混着空 commit:实测 7 个 commit 只有 2 个有货,--ci-count 7 就是 2 路干活、5 路空转,并发越高浪费越大。而且分片按索引轮转、不按文件数均分,两个有货的 commit(91 和 36)配 --ci-count 2,拿到的是 91 对 36,不是 64 对 63,慢的那路决定整批时间。
最后排掉会白烧的配置。 有个参数文件会被当作累计计时起点:剩余时间 = 上限 − (现在 − 触发时间),算出负值就直接退出,启动即退、零产出。一个陈旧的触发时间能把新的时限参数直接算成已过期。排查”启动就退”先看日志里那行打印了触发时间和剩余时间的记录。
一个脚本查额度
三个端点里,只有 charge/quota、charge/volume、charge/special-amount 是真实存在的。令牌从控制台生成后存进环境变量,别写进命令行历史。
import json, os, urllib.request

TOKEN = os.environ["CNB_TOKEN"]
ORG = "YOUR_ORG"
HDRS = {"Accept": "application/vnd.cnb.api+json",
        "Authorization": "Bearer " + TOKEN}


def get(path):
    req = urllib.request.Request(
        f"https://api.cnb.cool/{ORG}/-/charge/{path}", headers=HDRS)
    with urllib.request.urlopen(req, timeout=20) as r:
        return json.loads(r.read())


q = get("quota")            # 各计费项 {total, free}
v = get("volume")           # 已用量 + freeze_* 预冻结量
s = get("special-amount")   # 限时特权:默认全 null,有值就是特权

# 剩余核时 = (quota.total - volume.free - volume.freeze) / 3600
# 预冻结需求 = 分配核数 × 5 ÷ 60
for k in ("ci_in_sec", "dev_in_sec"):
    used = v.get(k, 0)
    print(k, "total", q[k]["total"], "free", q[k]["free"], "used", used)
print("special", {k: x for k, x in s.items() if x and "desc" in k})
写完之后核对两个数:quota.total 是否恰好等于 free(相等就是没绑预算),以及 special-amount 的描述字段里有没有值。有值说明那个多出来的量是平台送的限时特权,不是你的预算。
三个能带走的判断
单位不统一的信号会同时骗过你和你的直觉。 duration 这个字段名在同一份响应里就有两个单位:顶层是毫秒,嵌套在 pipeline 里的那个是秒。混用会把耗时算错 1000 倍。看到数量级不对,先怀疑单位。
滞后信号比错误信号更危险。 错误信号你迟早会发现,滞后信号看起来永远”稳定不变”,而”稳定不变”恰好是”卡死”的特征。宁可多采一次样、用增量判断,也别信状态字段。
自检比对外解释划算。 我在这 22 小时里反复更正自己,其中 4 次是完整的假警报。每次都是同一个模式:拿一个信号去否定另一个信号,而两者根本不是同一个事件。上报问题前把证据链读全,比事后解释便宜得多。