引言
一个季度的一百多笔账单明细,我想把它们整体迁进一木记账。
原计划半小时收工:下载导入模板,用脚本把支付宝 CSV 的列填进去,导完收工。结果是返工了四轮。中间有两版生成好的文件被我自己作废,还有一笔已经付款的真实消费差点被当成无效交易丢掉。
问题不在”格式转换”这件事上。真做下来,它是一次数据工程:编码识别、表头定位、交易语义分流、账户名精确匹配,最后还要跟官方统计做金额对账。这篇文章把这四步拆开讲,重点是那些一眼看不出来的地方。
第一步就卡住:文件读不进来
用文本编辑器打开支付宝导出的 CSV,第一眼是乱码。这个文件不是 UTF-8,是 GB18030。
解码要做回退,而不是直接指定一种编码:
from pathlib import Path

def decode_csv(path: Path) -> str:
    raw = path.read_bytes()          # 必须传 Path 对象,传字符串会 AttributeError
    for enc in ("utf-8", "gb18030"):
        try:
            return raw.decode(enc)
        except UnicodeDecodeError:
            continue
    raise ValueError("无法解码 CSV")
文件头部还有大约二十行导出说明,官方统计(共多少笔、收入多少、支出多少、不计收支多少)就藏在里面。这张统计表后面做对账要用,先别删。
真正的表头从 交易时间 那一行才开始。这里有个容易忽略的点:不要硬编码行号。不同时间导出的文件,头部说明的行数可能不一样,写死 第 23 行 迟早会翻车。用内容定位:
lines = text.splitlines()
header_idx = next(i for i, l in enumerate(lines)
                  if l.strip().startswith("交易时间"))
reader = csv.reader(lines[header_idx + 1:])
顺带一个 shell 层面的坑:支付宝导出的文件名通常带日期括号,比如 支付宝交易明细(20260624-20260929).csv。在 bash 里直接拼路径会报 syntax error near unexpected token '('。加引号,或者干脆把路径当参数传给 Python,别在 shell 里拼。
真正的坑:导出格式不等于导入模板
这是我返工四轮的根源。
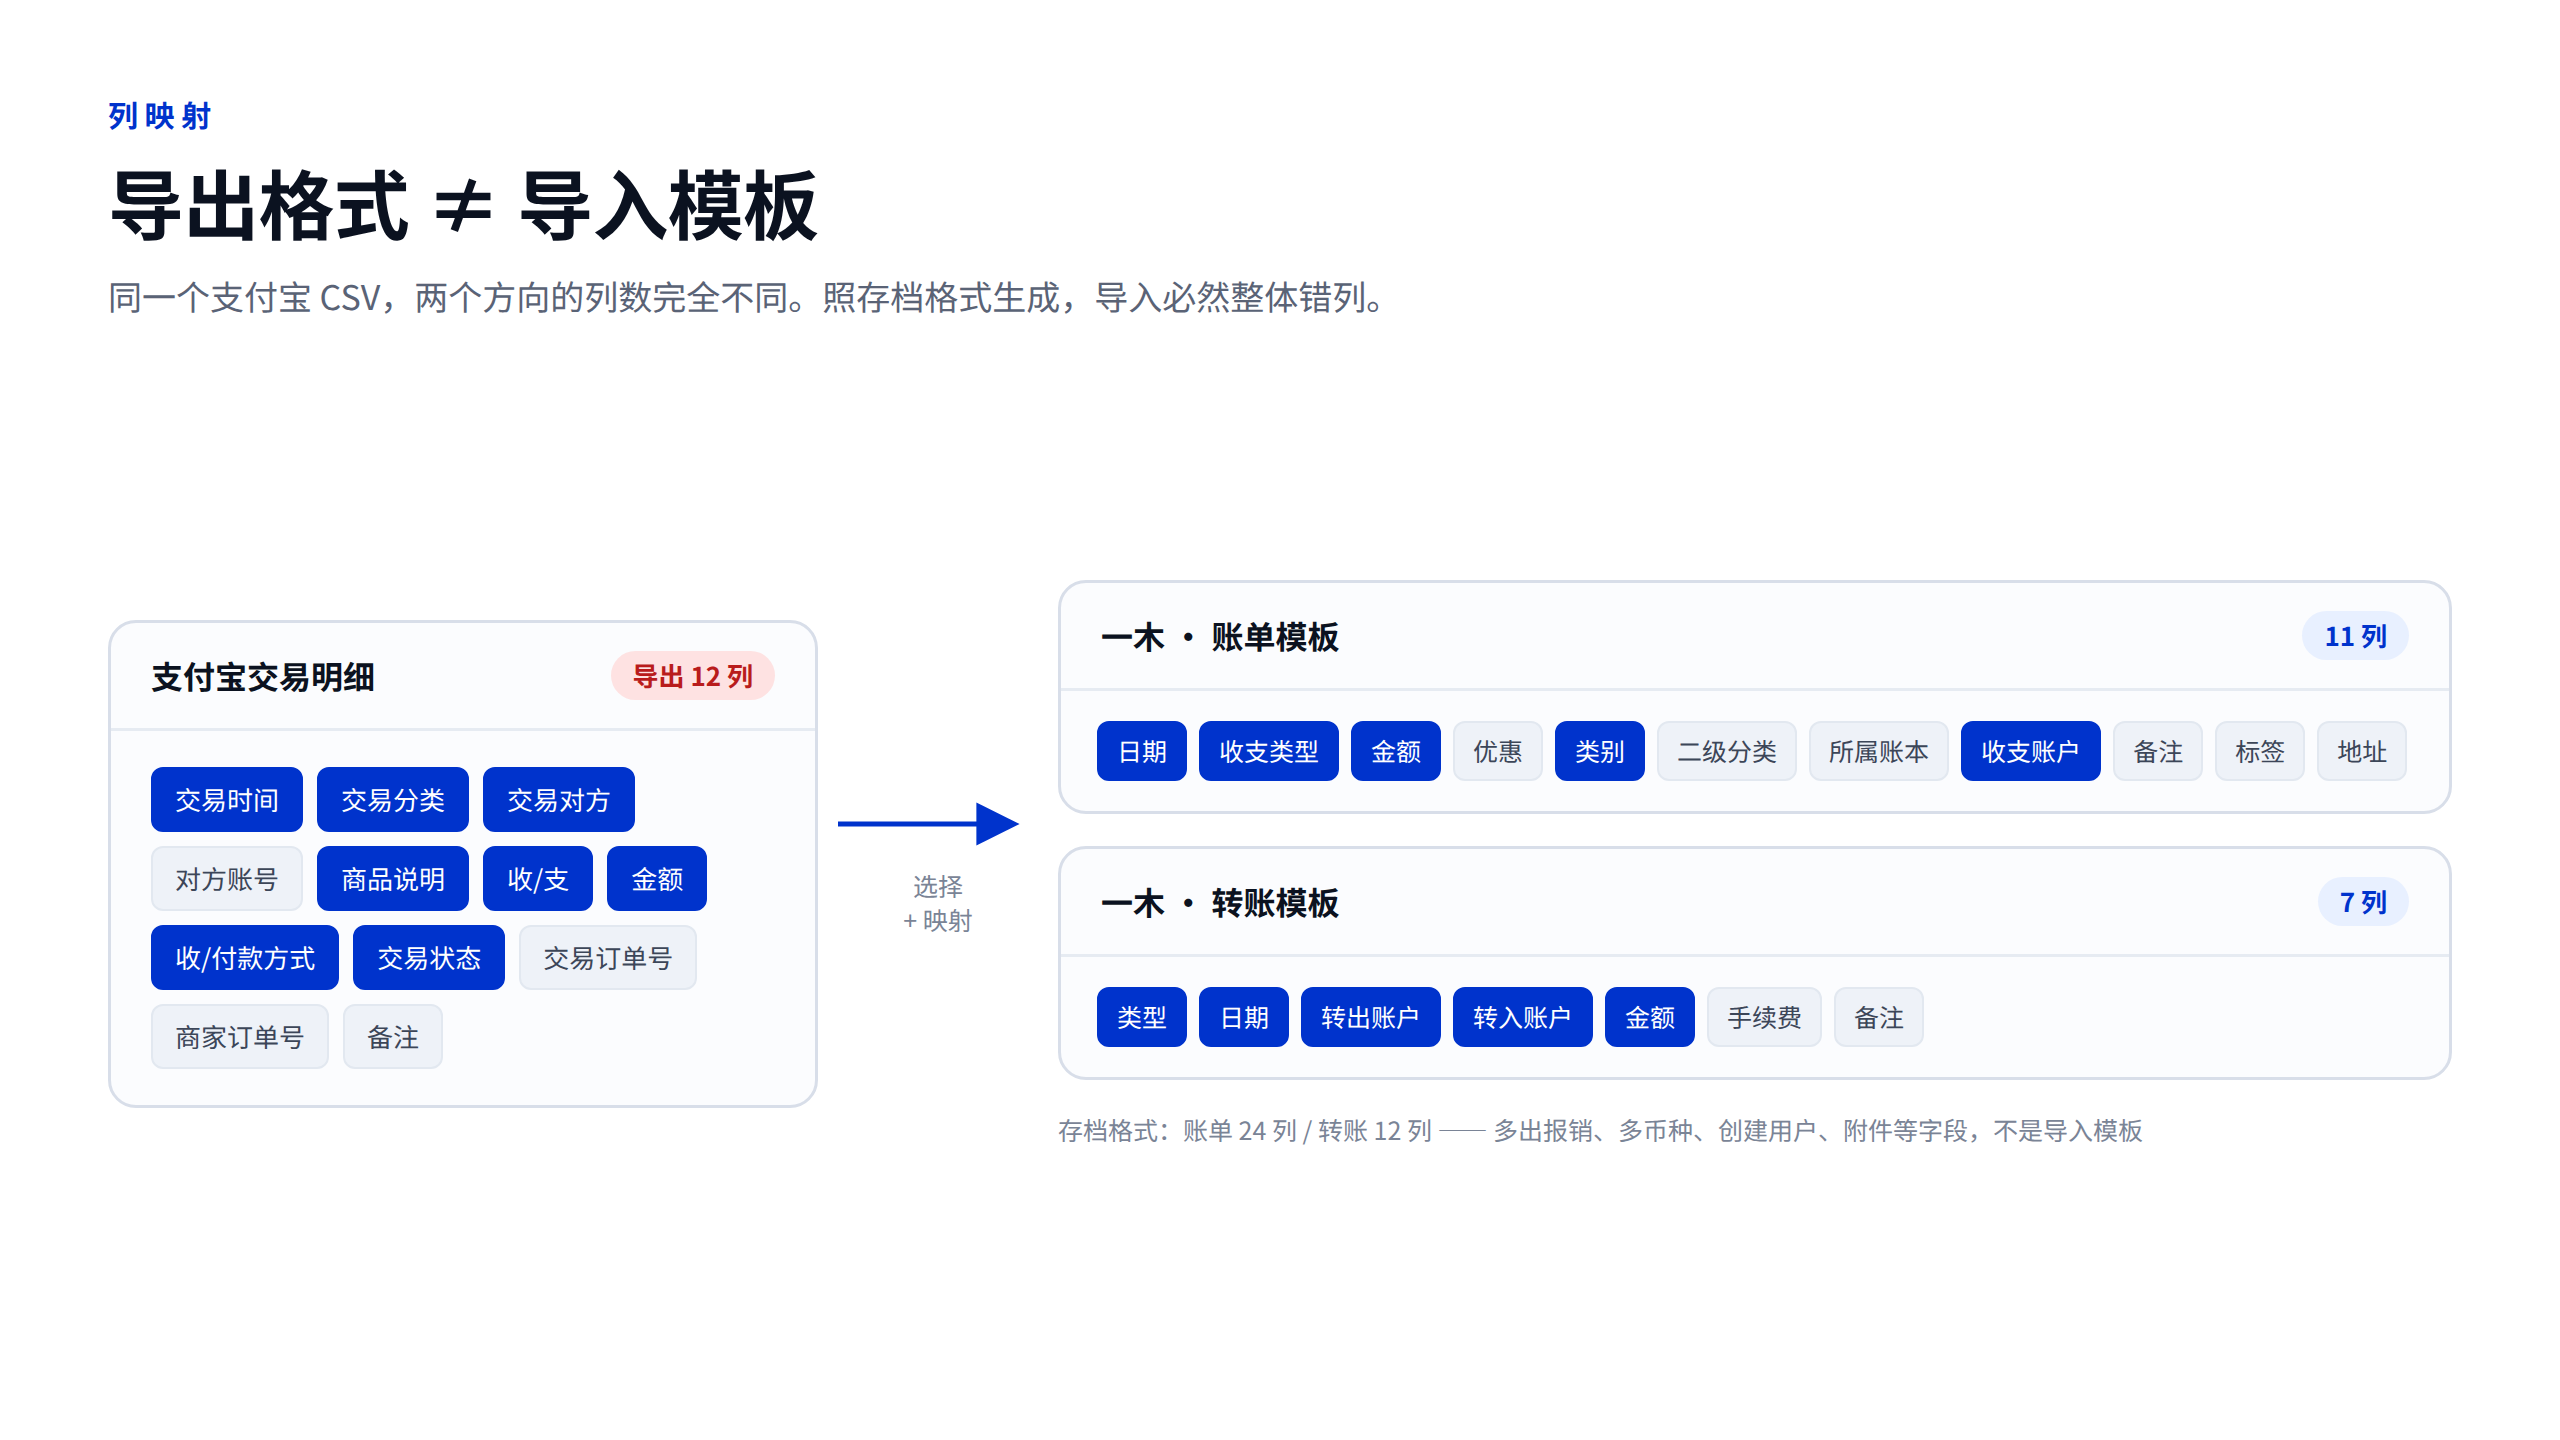
一木记账的官方导入模板分两类,列数是硬约束:
- 账单模板:11 列 —
日期 | 收支类型 | 金额 | 优惠 | 类别 | 二级分类 | 所属账本 | 收支账户 | 备注 | 标签 | 地址 - 转账模板:7 列 —
类型 | 日期 | 转出账户 | 转入账户 | 金额 | 手续费 | 备注
而我第一版脚本参考的是一份历史导出的文件,那份文件是 24 列和 12 列——多了 报销账户 / 报销金额 / 多币种 / 创建用户 / 附件1-5 这些字段。那是完整存档格式,不是导入模板。按它生成的表格,一木导入时会整体错列,每一列都对不上位置。
拿到模板后先数列数,一行命令的事:
# 打开官方模板,直接数列数
python3 -c "
import xlrd
sh = xlrd.open_workbook('模板.xls').sheet_by_index(0)
print(sh.ncols, [sh.cell_value(0, c) for c in range(sh.ncols)])
"
对照上表,11 列和 7 列才是能用的导入模板。等到导入报错再回头查,数据已经脏了。
| 账单 | 转账 | |
|---|---|---|
| 官方导入模板 | 11 列 | 7 列 |
| 存档 / 旧版导出格式 | 24 列 | 12 列 |
另外官方文档里有几条约束值得先确认:日期、收支类型、金额 三列必填;收支类型 只认 支出 和 收入;账户必须是 App 内已存在的账户,名字不匹配会直接新建一个重复账户;所有行的日期格式必须统一。
三种交易类型,重点是第三种
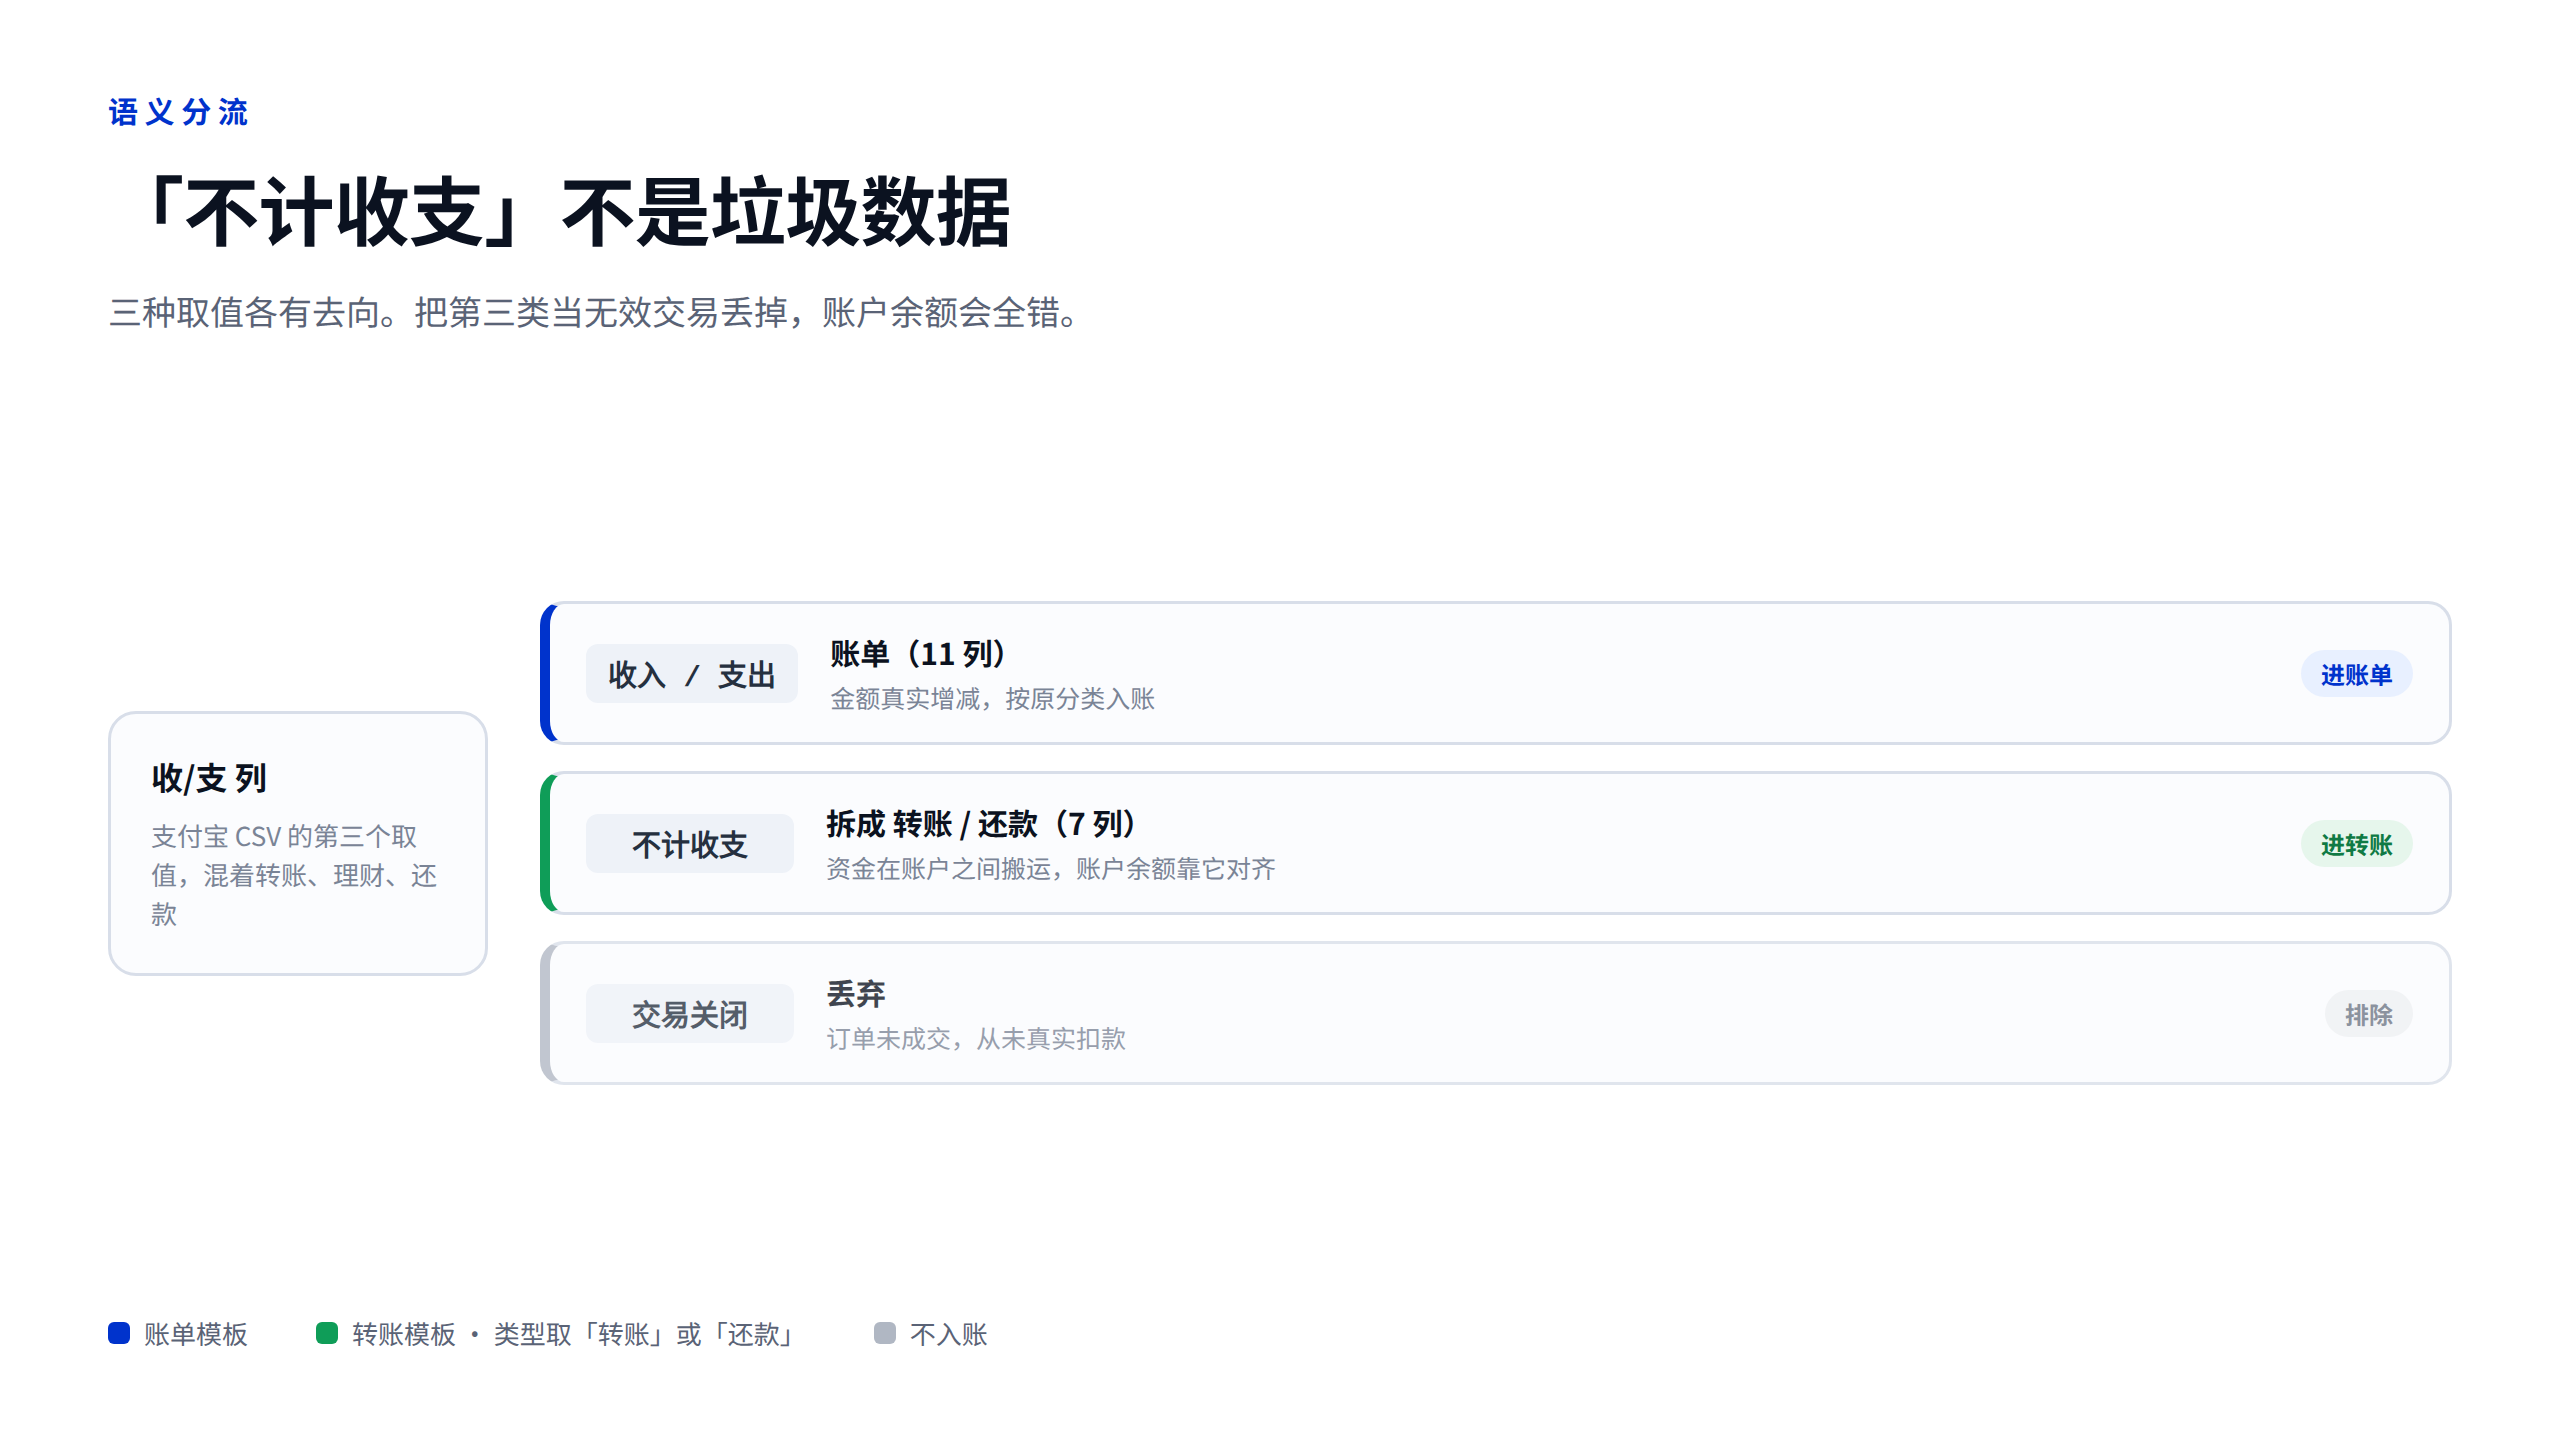
支付宝 CSV 的 收/支 列有三个取值。前两个好办,第三个是分水岭。
| 取值 | 处理 |
|---|---|
收入 |
进账单,收支类型=收入 |
支出 |
进账单,收支类型=支出 |
不计收支 |
不能跳过,要拆成转账或还款记录 |
不计收支 底下混着好几类交易:余额宝收益、基金买入与分红、余额宝转入转出、花呗自动还款、还贷管家转出、信用住冻结。它们在支付宝侧算”钱没花掉”,但在一木里必须变成账户之间的搬运,否则余额宝和银行卡的余额会全错。
我按商品说明做的分流规则:
| 识别特征 | 分流结果 |
|---|---|
收益发放 |
按月聚合,记为账单(收入 / 理财盈利) |
退款-* |
记为账单(收入 / 退款),冲抵原支出 |
蚂蚁财富-*-买入 |
转账:余额宝 → 基金买入中(临时) |
*-现金分红至余额宝 |
转账:基金买入中(临时) → 余额宝 |
余额宝-转出到银行卡 |
转账:余额宝 → 目标银行卡 |
余额宝-单次转入 |
转账:银行卡 → 余额宝 |
花呗自动还款-* |
还款:余额宝 → 花呗 |
余额宝-还贷管家转出 |
还款:余额宝 → 目标储蓄卡 |
飞猪信用住-冻结-* |
丢弃(占位交易,不是真实扣款) |
交易状态也要过滤,而且白名单容易漏:
# 只用于「收入 / 支出」分支;「不计收支」分支另有自己的状态处理
VALID_STATUS = {"交易成功", "支付成功", "等待确认收货"}
# 排除:交易关闭(订单被取消,没真正成交)
# 注意:还款类交易的状态是「还款成功」,不在上面这个集合里,
#      所以还款分支不能复用这个白名单,否则花呗自动还款会被整条筛掉
等待确认收货 属于真实消费,必须算。我第一轮漏了它,支出合计少了一百多块,跟官方统计对不上,查了一圈才发现是这里。还款成功 则是另一个方向的坑:它和上面三个状态互不重叠,如果把白名单当成全局过滤条件套在整份数据上,转账和还款记录会一起消失。
账户名:两处最容易写错的地方
一木的账户是提前在 App 里建好的,导入时靠字符串精确匹配。名字差一个字符,结果不是报错,而是悄悄新建一个账户。
第一处:账户名里的减号是 U+2212,不是 ASCII 的 -。
>>> for ch in "某储蓄卡−1234":
...     print(ch, hex(ord(ch)))
某 0x67d0
储 0x50a8
蓄 0x84c4
卡 0x5361
−  0x2212       # ← 数学减号,不是 ASCII 的 0x2d
用半角 - 拼出来的账户名,一木会认为是个新账户。验证方式就是把每个字符的码点打出来,看到 0x2212 才对。
第二处:余额宝转出的交易,商户名不带卡号。
余额宝-转出到银行卡 这类记录的商户名只有 中国建设银行、交通银行 这种银行名,没有卡号后缀。如果直接拿它当账户名,生成的就是 App 里不存在的账户。做法是补一层映射:
ACCOUNT_MAP = {
    # 带卡号后缀的完整写法
    "建设银行储蓄卡(A卡号)": "储蓄卡A",
    "中国建设银行储蓄卡(A卡号)": "储蓄卡A",
    # 余额宝转出的商户名不带卡号,必须补这两条
    "中国建设银行": "储蓄卡A",
    "交通银行储蓄卡(B卡号)": "信用卡B",
    "交通银行": "信用卡B",
    # 带优惠后缀的付款方式归并到主账户
    "花呗": "花呗", "花呗&红包": "花呗",
    "花呗&碰一下立减": "花呗", "余额宝": "余额宝",
}

def norm_account(acc: str) -> str:
    if not acc:
        return ""
    if acc in ACCOUNT_MAP:
        return ACCOUNT_MAP[acc]
    return acc
写完记得把映射结果逐字符打印一遍,确认减号是 0x2212。这一步看着多余,但它是导入前唯一能发现问题的地方。
花呗&红包、花呗&碰一下立减 这种带优惠后缀的付款方式也要一并归到 花呗,否则每出现一次立减,账户列表里就多一个。
还有一处值得单独说:账户语义靠猜一定会错。有一笔”还贷管家转出”,账户名里出现了另一家银行,我一开始就填了那家银行,后来翻备注才发现资金实际走的是储蓄卡,那家银行是负资产的信贷账户,还款只是记账上的动作。这种判断脚本做不了,要么看备注,要么问用户。
生成之后:对账是唯一可信的门禁
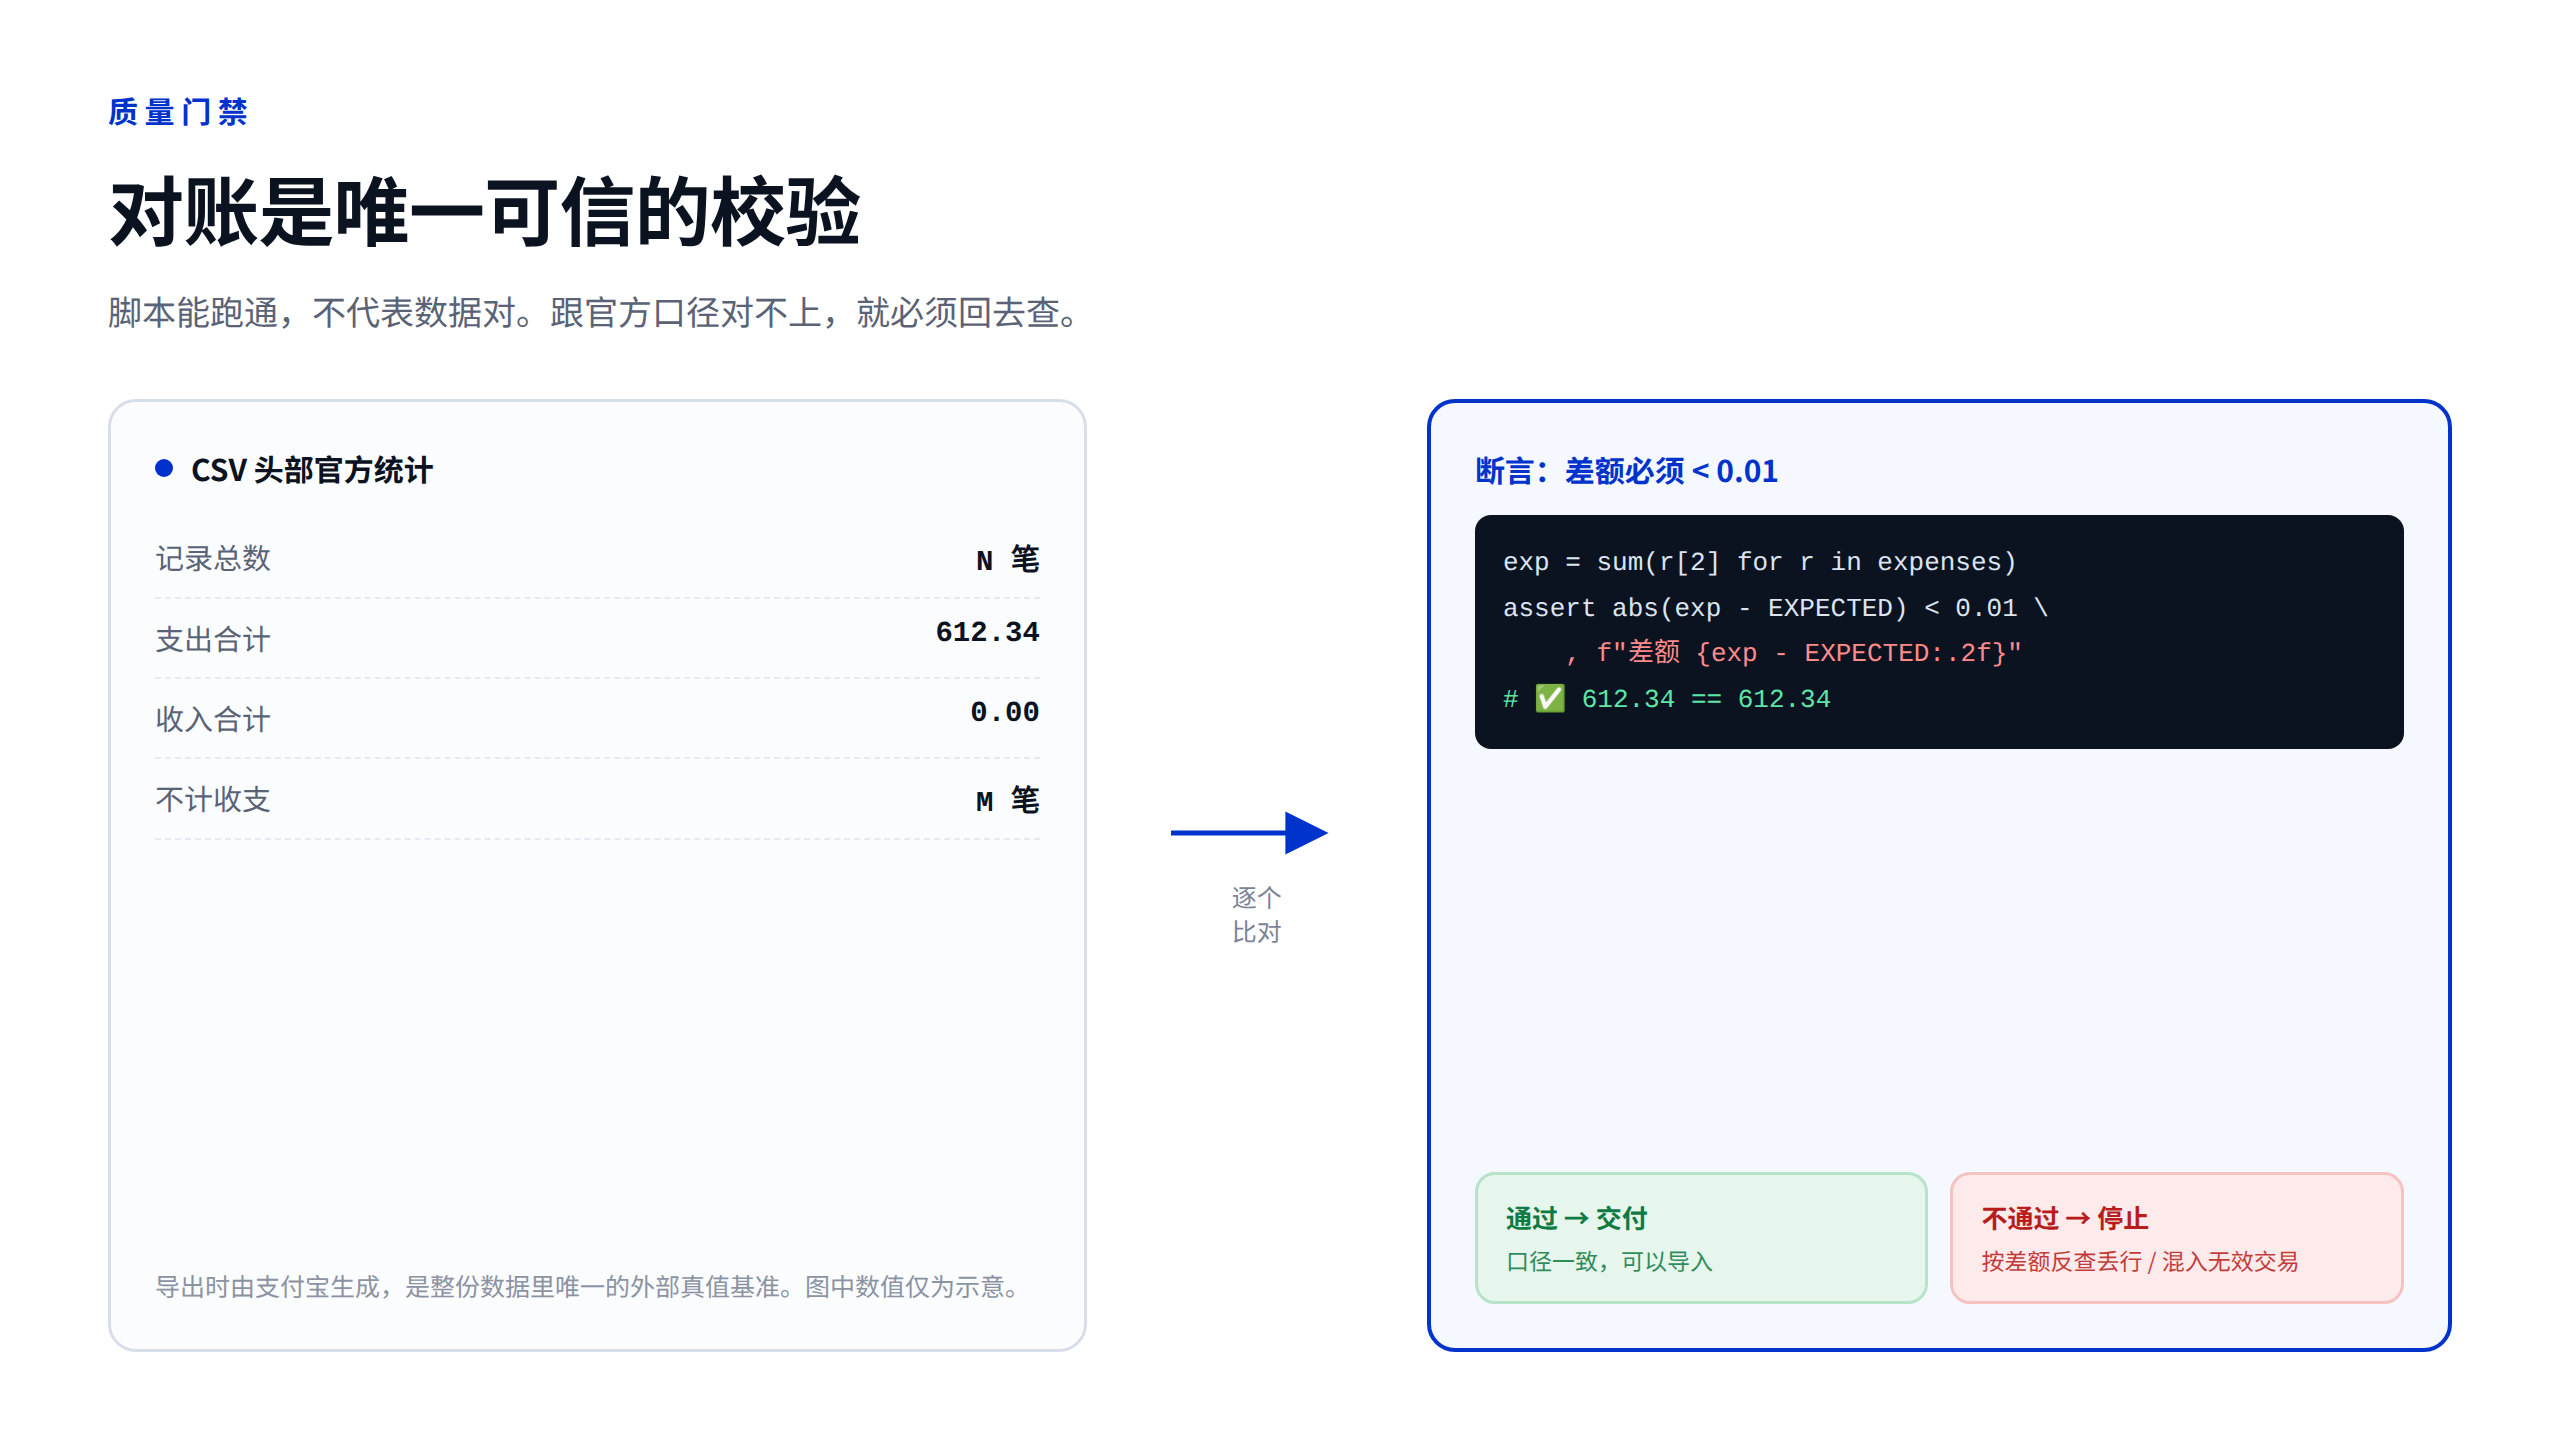
脚本跑通不等于数据对。唯一能证明没丢行的办法,是拿结果跟支付宝官方统计比。
exp_total = sum(r[2] for r in expenses)
assert abs(exp_total - EXPECTED) < 0.01, f"支出差额 {exp_total - EXPECTED:.2f}"
EXPECTED 从 CSV 头部那段官方统计里取。
# 第二个参数是 CSV 头部官方统计里的支出合计
python3 convert_alipay_to_yimu.py 支付宝交易明细.csv EXPECTED_TOTAL
# ✅ 支出金额匹配(与支付宝官方口径一致)
这个断言是整条流程里最有价值的一段代码。第一轮算出的总额比官方统计少了一百多块,差额直接指路——顺着它查,才发现是某个交易状态被漏掉了;补上之后严丝合缝。
退款也要计入。对应的原支出已经在账单里了,退款如果不记成收入,信用卡负债会虚增——原支出记了一笔,退款不记,等于同一笔钱算了两次。类别填 退款,一眼能跟普通收入区分。
生成完还要回读一次,确认列数没写错:
import xlrd
sh = xlrd.open_workbook("一木账单_导入.xls").sheet_by_index(0)
assert sh.ncols == 11, f"账单列数错误:{sh.ncols}"
.xls 这类旧版二进制格式,普通文本工具读不了,会报 UnsupportedError,得用 xlrd 打开。写文件用 xlwt,读文件用 xlrd。
其他几条路,看你的数据量
一木支持从部分记账 App 一键迁移(设置 → 导入/导出 → 第三方导入),但它只搬分类、金额、时间三项,转账和报销不搬。数据量小、不介意手工补齐的话,这条路最省事。零散补录可以直接用 App 内置的截图 OCR。
几十笔以内,手动填模板比写脚本快。上百笔,脚本才划算——这次的场景是一百多条记录,手动填一遍要耗掉大半个下午。截图批量导入也可以走 OCR:日期、金额、收支类型、备注能自动提,但类别和账户必须人工确认,因为 OCR 拿不到账户名,而账户名要跟 App 里已有的完全一致。
最后一句交付提醒:模板请用 Microsoft Excel 保存。WPS 等第三方办公软件有可能写出不兼容的格式,前面的对账全对,卡在导入这一步就白干了。
几个通用教训
迁移类任务里,真正的成本几乎都不在写代码上:
- 先拿约束物料,再动手。官方模板这类文件是任务的前置条件,不是背景资料。我这次拿到模板后拖了快一个小时才打开,中间按错误假设生成了两版文件。
- 列数、日期格式这类隐式约定,要显式校验。它们不会报错,只会让数据悄悄错位。
- 语义判断不能靠猜。一笔转账算转账还是还款、资金走哪张卡,脚本看不出来,得看备注或问人。
- 对账是唯一的质量门禁。跟官方口径能对上,才算做完。